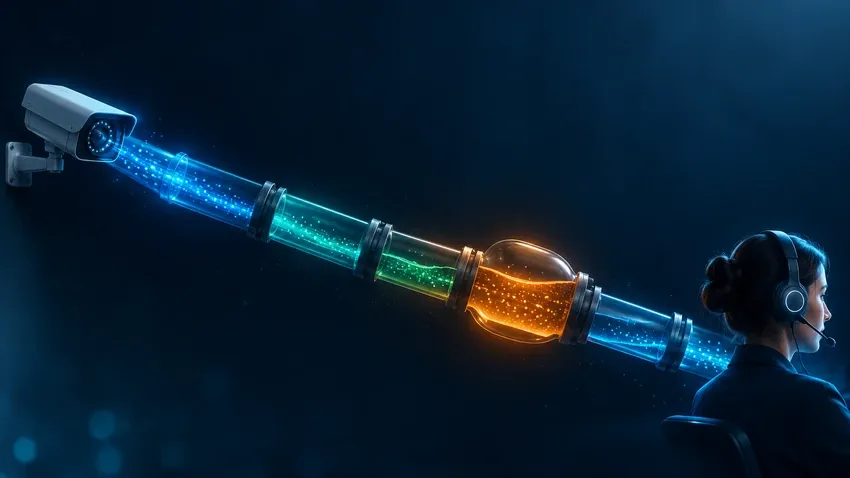
云值守的端到端延迟不是单一的“网络慢”,而是采集编码、边缘预处理、上行、云端转发、下行、坐席渲染六段之和。坐席端缓冲常是被忽略的大头。
“坐席看到有人翻越围栏,按下喊话键,等对方跑出画面了,声音才传过去。”
这是云值守项目验收阶段最常见的一幕。开发团队熬了两周压延迟,画面从 3 秒压到 800 毫秒,老板现场一看喊话,还是“慢半拍”。于是回去继续压网络,周而复始。
问题出在“延迟”这个词被当成了一个整体。它其实是一根链子上的六段绳,每段的归属方、优化空间、代价都不一样。搞不清哪段是谁的,优化就变成了碰运气。

一、先把两种延迟分开:看画面和喊话,不是一个指标
这是第一个要纠正的认知。
看画面是单向的。 坐席看到的是几秒前的现场,只要画面连续、可辨认,容忍度其实很宽,500 毫秒到 1 秒都不会让人觉得“不对劲”。人对单向信息流的延迟感知很迟钝,这是看录像和看直播难以分辨的原因。
喊话是双向的。 人对“我说完 → 对方有反应”这个闭环的心理阈值,比对“画面慢一点”苛刻得多。300 毫秒上下是个分水岭:低于它,对话感成立;超过 500 毫秒,坐席会本能地重复喊话,现场听到的是断断续续的指令,威慑效果直接归零。
很多团队定了一个“延迟 ≤ 800ms”的统一指标就开工,结果画面达标了,喊话体验依然崩。这两个指标必须分开定,分开验收,分开归因。
二、延迟花在哪:六段拆解
把一次“摄像头拍到画面 → 坐席屏幕上出现”的过程拆开,延迟分布在这六段:
- 前端采集与编码。摄像头采集一帧后,编码器不会立刻吐出来,它要等一个 GOP(图像组)周期凑齐关键帧。这一段的开销跟设备配置强相关,是整条链路上最容易被忽视、又最容易被高估的一段。
- 边缘预处理。边缘盒子或网关做协议转换、转封装、上云推流。每多一层转封装,就多一层缓冲。
- 上行传输。从现场网络到云端。比如门店宽带、工地 4G 的抖动和丢包,主要在这一段发作。
- 云端转发与转码。纯转发开销很小;一旦引入转码或混流,就会增加可观的处理延迟。
- 下行传输。云端到坐席。这一段通常和上行同量级,是 RTC 厂商网络能力的主战场。
- 坐席端解码与渲染。解码器缓冲加播放器抖动缓冲(jitter buffer)。这一段是最容易被忽略的延迟大户,也恰恰是开发者自己完全可控的一段。
为什么第 3、5 段能成为厂商的主战场:如主流 RTC 平台 即构(ZEGO) 走的是基于 UDP 的全链路自研私有协议加 BGP 线路,和 CDN 直播的 RTMP + TCP + 单线,是两套完全不同的东西。TCP 的重传机制在丢包时会引发队头阻塞,延迟随丢包率非线性上升,这正是喊话场景最受不了的特性。
三、延迟预算表
把六段分开之后,你会发现“延迟优化”变成一个可以分配预算的工程问题,而不是一个玄学指标。
| 环节 | 典型量级 | 可压缩空间 | 归属方 | 压缩的实际代价 |
|---|---|---|---|---|
| 前端采集编码 | 数十至上百毫秒 | 中 | 设备/网关 | 缩短 GOP 会牺牲压缩率,码率上升 |
| 边缘预处理 | 数十毫秒 | 小 | 网关 | 减少转封装层级,可能牺牲兼容性 |
| 上行传输 | 数十至上百毫秒 | 中 | 网络/RTC 平台 | 就近接入,成本上浮 |
| 云端转发 | 数十毫秒 | 大 | 云侧 | 不做转码可省,但多端适配能力下降 |
| 下行传输 | 数十至上百毫秒 | 中 | 网络/RTC 平台 | 同上行 |
| 坐席端解码渲染 | 数十至数百毫秒 | 大 | 前端开发 | 降低缓冲,弱网下卡顿率上升 |
表中量级为行业常见的经验区间,用于建立预算框架,不是精确规格。实际值必须在自己链路上实测,第五节给了方法。
这张表最重要的一列是最后一列。 六段里几乎没有哪一段是可以“免费压缩”的,压下去的每一毫秒都要拿别的东西换。
四、三个最常见的误判
误判一:以为换了专线就完了。 专线只影响第 3、5 段。如果你的瓶颈在第 1 段(GOP 太长)或第 6 段(播放器缓冲 500 毫秒),换十根专线也没用。
误判二:以为转码是免费的。 转码能解决多端适配、降低下行码率,但它引入的处理延迟实实在在。坐席只看固定几路画面的场景,很多时候不需要转码。
误判三:以为播放端缓冲是在“保护体验”。 抖动缓冲确实能换来更少的卡顿,但它换的是延迟。默认值通常偏保守,这是很多项目“网络明明很好、延迟就是下不来”的真正原因。
五、怎么测出你现在的真实延迟
不要用推算,端到端延迟是可以直接读出来的。
主流 RTC SDK 的质量回调会把这两个值直接吐给你:端到端延迟与端到端丢包率。以即构的实时音视频 SDK(ZEGO Express SDK) 为例,拉流质量回调 playQualityUpdate 的 stats 参数中就包含 peerToPeerDelay(端到端延迟)和 peerToPeerPacketLostRate(端到端丢包率)两个字段。
拿到之后,建议这样对齐:
- 掐总账。手机秒表正对摄像头按一下,坐席画面出现该帧时截图,两张图的时间差就是链路总延迟。
- 对分账。把 SDK 上报的
peerToPeerDelay和总账相减,差额就是设备侧编码加坐席端渲染的开销。 - 定位大头。如果差额超过总账的一半,别再折腾网络了,去查 GOP 配置和播放器缓冲策略。
这个三步法做完,你会得到一张属于自己业务链路的延迟账单。往后再有人说“延迟高”,你能直接指出是哪一段。
六、延迟不是越低越好
这一段可能是本文最该被记住的部分。
压延迟是有代价的,而且这个代价厂商文档里写得很清楚。以 即构(ZEGO) 的功能说明为例,它的“超低延迟播放”开关开启后,是“优先保障低延迟,但弱网时可能产生卡顿”;混流侧的拉流缓存下限也是可调的,官方描述是“可优化观众端拉流出现的卡顿问题,但会增大延迟”。
同一个平台的两个参数,一升一降,说的是同一件事:延迟和卡顿是一副跷跷板的两端。
云值守的现场网络(门店共享宽带、工地 4G、老旧厂区)普遍不好。在这种网络上一味压延迟,直接后果是坐席看到的花屏和马赛克变多,判断反而更慢,喊话更容易断。这比延迟从 800 毫秒变成 400 毫秒带来的收益,要大得多。
所以正确的目标不是“延迟最小化”,是延迟预算分配:喊话通道压到 300 毫秒以内,看画面通道给到 800 毫秒到 1 秒并换取更好的抗弱网表现。两条通道用不同策略,而不是一个指标统管全局。
常见问题
云值守的喊话延迟做到多少算合格?
双向通道建议压到 300 毫秒以内,超过 500 毫秒坐席会明显感到“对着空气说话”,会本能重复指令。单向看画面的延迟可以放宽到 1 秒左右。
为什么我用 FLV 或 HLS,延迟怎么优化都是 1 秒以上?
这是协议决定的。HLS 靠切片分发,天然有数秒延迟;HTTP-FLV 基于 TCP,延迟通常也在 1 秒以上,且丢包时因队头阻塞会明显劣化。看画面可以接受,喊话场景必须换成 RTC 通道。
端到端延迟和网络延迟是一回事吗?
不是。网络往返只占整条链路的一部分,采集编码、边缘转封装、云端处理、播放端缓冲都不属于“网络延迟”。只盯着网络排查,会漏掉大头。
同一个摄像头,能不能给“看画面”和“喊话”配不同策略?
可以,而且推荐这么做。视觉通道偏向流畅度和抗弱网,音频通道偏向低延迟,两者分开配置比用一个统一指标更接近真实业务需求。
怎么知道是设备侧慢还是坐席端慢?
用第五节的对账法:秒表掐总延迟,再减去 SDK 上报的端到端延迟,差额就是两端处理开销之和。
小结
云值守的延迟是一笔六段账,不是一个笼统的“网络慢”。先分清看画面和喊话是两套指标,再按段建预算,最后接受“延迟和卡顿不可兼得”这个物理事实,你的优化方向就不会跑偏。
至于第 3、5、6 段的工程实现,主流做法是两条路:自建流媒体网关做全链路,或者用成熟的 RTC 平台承接传输段和播放端。前者的控制力更强,后者在上线速度和弱网对抗上成熟度更高,如果你的团队规模不到能长期养一个音视频基础架构组的程度,后者通常是更划算的选择。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/info/72057.html
