第一人称视觉交互要求 Agent 在动态社会环境中通过多模态对话和工具使用解决真实世界任务。EgoInteract 将采样帧视为视觉假设,维护证据账本,并通过官方工具将可见实体规范化。场景感知服务 Agent 在零售、餐厅、厨房和点餐任务中自适应调整定位、分支选择和工具使用规则;范围受限的自纠正 Agent 在状态变更调用和最终回复对外可见之前进行审计,检查其是否得到对话、视觉假设、工具观测和当前状态的支持。在 EgoLink Track 2 官方最终评测中,EgoInteract 在已公布队伍中排名第一,取得 0.844 的联合成功率和 0.916 的微平均准确率。消融实验表明,场景感知提示是主要增益来源,自纠正机制则为无依据操作提供了针对性防护。
来源:ACM MM 2026 EgoLink Challenge Track 2
https://ego-link.github.io/challenge2026/#leaderboard
成员:Punan Dai, Yanxi Wu, Lingxin Chu, Jun Xu, Zhengxue Cheng, Li Song (SJTU MediaLab)
代码:https://github.com/Lance-dpn/EgoBench.git
内容整理:代普南
一、引言
EgoLink 的全称是 Egocentric Language-Vision Interactive Network Knowledge Challenge,由蚂蚁集团和浙江大学联合主办,作为 ACM MM 2026 的 Grand Challenge 之一。官方将其定位为“重新定义具身智能体在社会场景中的认知边界”——当前具身 AI 研究大多侧重物理导航,却忽视了深度的社会理解;EgoLink 要弥合的正是“视频描述”与“社会认知”之间、以及“感知”与“行动”之间的两道鸿沟。
比赛设两个赛道。Track 1 聚焦第一人称视频中的社会推理(情绪感知、因果推断、行为意图预测等)。Track 2 为 Interactive Agent in Social Life Scenarios(社会生活场景下的交互式 Agent),评估一个交互式 Agent 是否能在动态社会环境中通过多模态对话和工具使用解决真实世界任务。Agent 接收第一人称视频流(如购物、点餐场景)、自然语言指令和一组外部工具,需要完成多轮对话、从视觉证据构建正确的工具输入、解读工具输出并闭环执行。场景覆盖零售购物、厨房操作、餐厅点餐和多餐厅点餐四类,底层基准为 EgoBench——首个面向工具使用 Agent 的交互式第一人称多模态基准,包含 1045个任务。
官方明确了三个核心评估维度。其一是细粒度第一人称视觉理解:从连续视频或图像序列中感知物体状态的时空关系,识别颜色、形状、纹理、品牌等属性。其二是动态工具调用与执行:决定何时调用哪个工具,从视觉证据(如屏幕上的价格、菜单选项)构建正确的输入参数,解读工具输出并选择下一步动作(完成、重试或切换策略)。其三是多跳逻辑推理与复杂决策:处理条件推理(“如果……那么……”)以及长对话和多物体场景中的多指代消解。
评估方式采用过程与结果联合验证的确定性框架:Tool Success 衡量 Agent 是否覆盖所有必要的工具调用步骤(过程匹配),Result Success 衡量 Agent 产生的最终数据库状态是否与标准答案一致(结果匹配),Joint Success 要求两者同时成立,Micro Accuracy 则在工具调用级别统计部分正确率。
现有被动视觉语言模型可以描述第一人称内容,但不能可靠地将目标规范化或执行状态变更操作;通用工具使用 Agent 可以调用 API,但通常假设实体和约束以文本形式给出。在第一人称服务交互中,目标本身往往是视觉的、模糊的且依赖场景的。可靠完成需要一条横跨视觉证据、工具观测、对话状态和执行约束的统一证据链。
EgoInteract 正是针对这一问题提出的推理时框架。其主要设计如下:
- 提出场景感知服务 Agent 框架,将定位、规范化、分支选择和工具使用规则适配到各场景的特定结构和数据库约定。
- 提出范围受限的执行前纠正机制,对照对话、工具证据、计算结果和当前状态审计状态变更调用与最终回复。
- 在 EgoLink 官方最终任务上报告性能与消融结果,表明 EgoInteract 在已公布队伍中排名第一,且两个组件均能提升任务完成率。
二、方法
1. 概览
我们将服务交互视为基于证据的决策过程。每一轮中,Agent 观测对话、可用工具、先前工具输出和必要时的视觉上下文,然后选择是收集更多证据、执行工具动作还是回答用户。核心风险在于模糊的视觉线索和依赖模式的工具可能导致过早的状态变更。
系统由两个 Agent 组成。服务 Agent 形成视觉和语言假设,通过官方工具规范化,并提出下一步动作;自纠正 Agent 审计状态变更调用和最终回复的证据充分性。被拒绝的提案不执行,其反馈返回服务 Agent 用于重新规划。
EgoInteract 维护一个证据账本,记录对话状态、视觉假设、工具调用、观测结果、计算值和已成功执行的状态变更。服务 Agent 用账本规划下一步最小动作,纠正 Agent 用账本检查对外可见的提案是否有充分支持。这使得感知、检索、推理和验证保持连接,而不将任何单一来源视为充分条件。
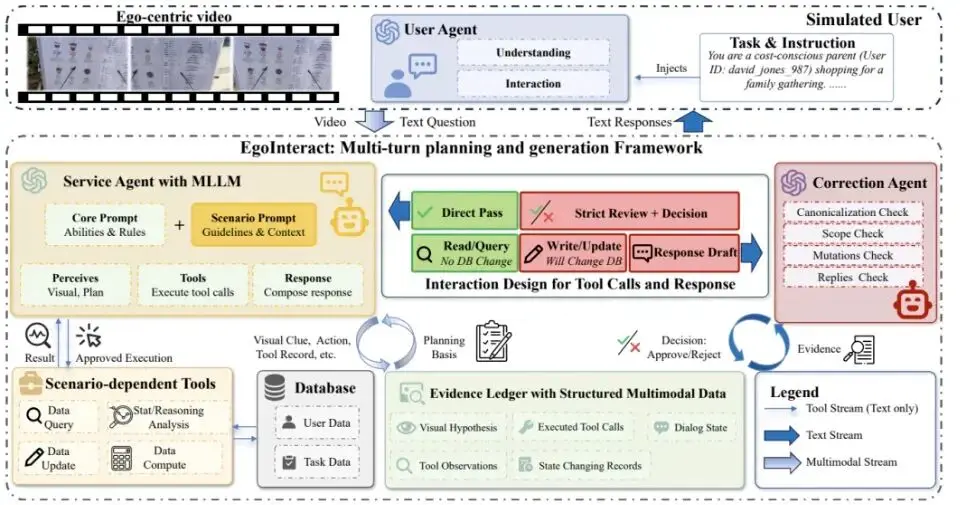

服务 Agent 用第一人称视觉假设和工具证据定位用户意图,自纠正 Agent 审计高风险提案是否有充分支持。
2. 视觉定位
视觉定位是假设阶段,而非最终数据库事实的来源。从采样帧中,服务 Agent 推断可能的指代对象,包括可见文字、物体身份、动作、区域、指向顺序、空间关系和局部上下文。这些假设决定下一步寻求哪些证据,其本身不构成数据库主张或变更的依据。
Agent 仅在需要时请求视觉上下文。可由对话和工具证据解决的轮次直接跳过帧请求,视觉或指代请求则触发基于帧的定位。每个可见产品、菜品、食材、菜单区域或选中物品随后通过官方工具映射到规范数据库字段。最终的名称、分类、价格、营养成分、库存和订单状态一律来自工具观测。若多个锚点仍可能成立,服务 Agent 继续收集只读证据,而非执行变更操作。
视频帧采用自适应采样:retail6 为 1fps,retail10 和 kitchen4 为 0.5fps,restaurant5 为 1fps,order2 为 2fps。每帧缩放到长边 1920像素,以高图像细节模式提交。
3. 场景感知服务 Agent
不同场景在视觉结构、工具语义和数据库约定上差异显著。零售任务强调包装识别和产品事实,餐厅任务使用菜单区域、菜品和分类,厨房任务结合食材、动作、食谱、库存和食材分类,点餐任务则分离餐厅身份、菜单项、套餐、订单状态和支付计算。
EgoInteract 采用通用策略加场景技能的两层结构。通用策略是一个有序检查清单:识别当前场景和请求分支、解析视觉锚点、检索规范记录、构建候选集、应用过滤或排序、延迟执行变更直到目标、数量和前置条件均有证据支撑。场景技能则在该骨架上填充领域知识:零售场景规定包装文字和货架位置来自帧、商品事实和购物车状态来自工具;餐厅场景将指代分为指向菜品、分类定位和分类内选菜三类,并在排序时保持已定位菜单区域稳定;厨房场景将可见食材匹配到官方食材名,再联动食谱、库存和分类工具;点餐场景强调餐厅名必须来自用户对话而非 OCR,严格区分单品操作与套餐操作,支付金额必须使用指定计算工具。
4. 自纠正 Agent
第一人称工具调用任务的依赖链很长:一个视觉指代可能激活某个分支,分支定义候选边界,边界需要多次工具查询,最后才能决定是否变更状态。在此链条中,Agent 可能选错分支、将工具结果用于超出其范围的场景,或在证据不足时过早写入数据库。
EgoInteract 增设自纠正 Agent 作为范围受限的证据审计器。它不执行视觉识别,不看图片,也不替代服务 Agent 做规划,仅检查服务 Agent 提出的高风险提案(状态变更工具调用或最终回复)是否得到对话、视觉假设、工具账本、当前状态、活跃分支、规范目标、数量和所需计算的支持。
其输出紧凑:批准、拒绝、要求更多证据或修改最终回复。拒绝时仅返回缺失的证据或违反的约束,不添加新的视觉判断,也不给出替代方案,使其反馈始终是审计信号而非竞争性规划。
审计粒度有所区分。只读查询(查价格、查过敏原、查分类)走快速通道,因为它们仅扩充证据账本,后续观测仍可纠正;写操作(加购物车、删菜品、更新订单)和最终回复必须走审计通道,因为它们一旦执行就会改变轨迹或被用户看到。纠正最多进行五轮。
图 2 展示了纠正 Agent 在 retail10 任务中的实际作用。第二轮中,服务 Agent 试图直接回答“第三盒白色包装的饼干不含大豆”,纠正 Agent 将其打回——白色包装仅是视觉假设,尚未通过工具查询规范名称,不能直接下结论。服务 Agent 随后调用 get_category 查到规范名为 desobry speculoos,再查过敏原列表确认不含大豆,该回复才被批准。

5. 服务—纠正交互
两个 Agent 通过提案—审计—重规划循环协作。服务 Agent 提出下一步动作,低风险的只读调用直接执行并记入账本,高风险提案提交纠正 Agent。审计通过则执行,观测结果成为新证据;审计不通过则不执行、不展示给用户,仅将缺失证据的紧凑反馈返回服务 Agent 重新规划。
运行时上,只读调用遵循快速路径,因为它们扩充证据账本且可被后续观测纠正;状态变更调用和最终回复遵循审计路径,因为它们决定轨迹或用户可见响应。执行后观测追加到账本,拒绝后对话和工具状态保持不变,被拒提案替换为内部纠正反馈用于重规划。
实现上,两个 Agent 均使用 GPT-5.5 端点,temperature 设为 0。服务 Agent 使用低推理力度,纠正 Agent 使用中等推理力度——初步实验表明,提高服务 Agent 的推理力度并不能稳定改善视觉定位,因此将更强的推理留给审计节点。
三、实验
1. 评测设置
我们在 96个官方 Track 2 最终任务上评估 EgoInteract,覆盖五个场景。所有分数由官方评测器计算:Tool Success 衡量过程匹配,Result Success 衡量最终数据库状态匹配,Joint Success 要求两者同时成立,Micro Accuracy 为官方调用级别聚合指标。系统为纯推理时,无训练或微调。
2. 主要结果

关键分析 :以 Joint 为排名指标,EgoInteract 在已公布的前五名队伍中排名第一,取得 0.844 Joint、0.916 Micro、0.875 Result 和 0.854 Tool。Result 分数高于 Tool 分数,表明部分轨迹虽最终数据库状态正确,但严格流程指标识别出工具步骤的缺失或错配。
分场景结果显示,retail6 和 kitchen4 表现最强,其中 retail6 取得满分。order2 较难,因为它在混合单品和套餐操作、订单状态依赖和支付计算上提出了更复杂的视觉推理要求。retail10 同样具有视觉挑战性:商品形状、标签与物品的关联以及空间定位使得在将视觉选择带入购物车更新之前准确锁定商品本身较为困难。

3. 消融实验
在相同的最终任务和评测器上,分别移除纠正 Agent、场景规则以及两者同时移除。

关键分析 :移除纠正 Agent 后 Joint Success 从 0.844 降至 0.781,表明审计能够拦截无依据的状态变更、参数错误和与工具观测不一致的最终回复。移除场景规则导致更大幅度的下降至 0.646,确认场景特定的定位和工具使用规则是系统的核心。双重消融仅比单独移除场景规则略差,表明纠正 Agent 在规划器已能提出合理工具链时最为有用。
分场景来看,场景规则在 kitchen、order 和 restaurant 上影响最广,因为食材分类、套餐区分和菜单定位直接决定有效分支的选择;纠正 Agent 在 kitchen 和 retail 上效果更明显,因为这些场景的写操作较多,审计价值更大。
定性案例进一步补充了聚合分数。在 order2 第 20 个任务中,完整系统正确移除了折扣最小的非套餐单品,并通过指定计算工具回答了更新后的营养和支付金额。去掉场景规则的版本将工具返回的折扣系数误解为实际折扣,因而移除了错误的商品。去掉纠正的版本虽能产生正确的最终数值结果,但绕过了指定的计算工具自行计算,违反了预期的工具使用流程,因此 Tool 和 Joint 仍被扣分。这一案例说明,结果正确不代表过程正确,过程正确也不代表结果正确,两者同时成立才是 EgoLink 联合评估的要求。
四、结论
EgoInteract 是一套面向 EgoLink 风格第一人称服务交互的推理时多模态 Agent 系统,结合视觉定位、基于工具的规范化、场景感知规划和范围受限的纠正,使得视觉情境化请求可以转化为有依据的工具动作和最终回复。在官方 EgoLink Track 2 最终评测中,EgoInteract 在已公布队伍中排名第一,取得 0.844 联合成功率和 0.916 微平均准确率。消融实验进一步表明,场景感知提示是主要贡献因素,纠正机制则为无依据操作和流程错误提供针对性防护。这些结果表明,可靠的第一人称 Agent 同时需要场景特定的定位规则和执行前验证,尤其是在最终状态正确性与工具使用流程正确性被联合评估时。
代码已开源在 GitHub(https://github.com/Lance-dpn/EgoBench.git),欢迎交流与复现。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


