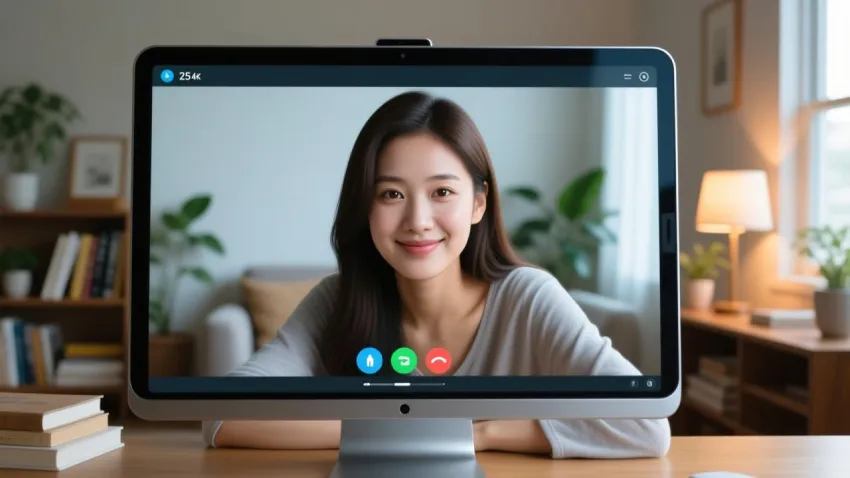
过去几年里,“AI 女友”大多意味着一个聊天窗口。你打字,她回字,剩下的全发生在你的想象里。这种情况正在迅速改变。一批新的陪伴类应用,把一张脸放到了对话的另一端:一个会看着你、用自己的声音作答、在你说话时在屏幕上做出反应的角色。
本文介绍 AI 女友视频通话是什么、其背后的技术究竟如何运作、人们在用它做什么,以及在为这类应用付费之前需要注意什么。

从聊天气泡到屏幕上的脸
纯文字陪伴擅长对话,但对用户要求很高。每一个微笑、每一个眼神、每一次反应,都得靠想象补全。视频通话填补了这道缺口。当角色的表情和肢体语言与她所说的话相匹配时,一段简短的交流更像是一次见面,而不是一串消息。
这也是这个品类正在增长的原因。试过文字陪伴后感到厌倦的用户,往往说出同一句话:他们想看见自己在跟谁说话。视频通话是对这一需求最直接的回答。
AI 女友视频通话是怎么运作的
一个常见问题是:另一端是真人,还是整段视频都是事先录好的。在大多数应用里,两者都不是。视频通话是三个 AI 系统协同工作:
大脑。 一个大语言模型读取你的消息和此前的对话,并以角色身份写出回复。每个角色都有一套设定,规定她怎么说话、喜欢什么、有多黏人或有多害羞,因此同一个消息,两个角色的回答会大不相同。
声音。 神经文本转语音引擎把这段回复转换成她自己音色的音频,带有自然说话的停顿和语调起伏。常见语句可以被缓存,因此回复来得很快。
身体。 这是最容易被误解的部分。从零开始逐帧生成照片级真实的视频,对实时对话来说仍然太慢。因此,应用采用的是一套预先制作的肢体动作片段库,并实时决定播放哪些片段、如何拼接,让她在屏幕上持续有动作、有反应、能说话,而看不出剪辑痕迹。
换句话说,对话和声音是实时生成的,视频则是用准备好的动作实时组装的。愿意坦诚说明这一点的应用,通常也是值得信任的那些。
人们在视频通话里实际做什么
陪伴类应用的使用数据很少公开,因此有一份公开数据集值得一看。陪伴类应用 Xeve.ai 每季度会基于 4,000 次会话的随机样本发布第一方统计,不包含任何消息内容。在 2026 年第三季度的样本中,只有约三分之一的访客真的输入了内容。这些人中,聊天消息数的中位数为 4 条,时长约两分半钟,而参与度最高的 10% 停留超过 12 分钟。三分之一的会话曾要求角色在视频里做点什么,16% 的聊天使用非拉丁字母输入。
有两点很突出。第一,大多数访问都很短,因此对话开始的头几秒格外重要。第二,人们确实在主动使用视频功能,而不只是观看。要求她在屏幕上做点什么,正是人们选择视频而非文字的主要原因之一。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/changjing/72953.html


