论文: Zipper-LoRA: Dynamic Parameter Decoupling for Speech-LLM Based Multilingual Speech Recognition
作者: Yuxiang Mei; Delai Qiu; Shengping Liu; Jiaen Liang; Yanhua Long
IEEE Xplore: https://ieeexplore.ieee.org/document/11636226
arXiv: https://arxiv.org/abs/2603.17558
github:https://github.com/YuCeong-May/Zipper-LoRA
huggingface:https://huggingface.co/YuCeong-May/Zipper-LoRA
近年来,大语言模型(LLM)与语音编码器结合形成的 Speech-LLM 在自动语音识别(ASR)领域取得了显著进展。然而,大规模 Speech-LLM 通常拥有数十亿参数,直接针对不同语言进行全参数微调,不仅训练成本高,而且难以扩展到大量语言。
因此,LoRA(Low-Rank Adaptation)等参数高效微调(PEFT)方法逐渐成为 Speech-LLM 微调的主流方案,仅需训练少量参数即可完成模型适配。
然而,在多语种尤其是长尾语言场景下,传统 LoRA 将所有语言共享同一组低秩参数,容易产生跨语言干扰(Cross-lingual Interference),导致低资源语言性能下降,限制了模型进一步提升。
技术难点


本工作主要面临以下几个挑战:
1. 共享参数导致跨语言负迁移
多种语言共同更新同一组 LoRA 参数,不同语言梯度方向存在冲突,容易互相干扰。
2. 语言间共享与特异知识难以平衡
不同语言既存在共性的语音知识,也具有各自独特的语言特征,如何合理划分共享信息和语言专属信息,是提升模型性能的关键。
3. 长尾数据分布更加严重
多语种训练通常呈现明显的长尾分布,高资源语言容易主导参数更新,使低资源语言获得的有效学习能力不足。
创新方案
针对上述问题,本工作提出了一种新的参数高效微调框架 Zipper-LoRA(动态参数解耦 LoRA)。


1、Rank 级参数解耦
本工作将 LoRA 的低秩空间划分为
- Shared Rank(共享知识)
- Language-specific Rank(语言特有知识)
不同语言根据自身特点动态组合两部分参数,实现共享能力与语言个性的统一。
2、动态路由机制
提出动态 Rank Routing 方法,根据语言自动决定每个 Rank 的共享程度,而不是传统方法固定共享全部参数。
进一步设计了
- Hard Routing
- Soft Routing
其中 Soft Routing 采用连续权重融合方式,使共享与独立之间能够实现更加平滑的过渡。
3、Warm Initialization
为了提高训练稳定性,又设计了 Initial-B 初始化策略,有效缓解动态路由早期训练不稳定的问题,加速模型收敛。
实验效果
在Whisper-large-v3 + Qwen3-1.7B Speech-LLM 框架上,对 Zipper-LoRA 进行了系统验证。实验覆盖 12 种语言、高资源与低资源场景以及Chunked / Non-Chunked Encoder 两种编码器配置,全面评估了方法的泛化能力与稳定性。
实验语言包括:
- 高资源语言:泰语(th)、英语(en)、德语(de)、西班牙语(es)、法语(fr)、意大利语(it)、俄语(ru)、越南语(vi);
- 低资源语言:阿拉伯语(ar)、日语(ja)、韩语(ko)、葡萄牙语(pt)。
1、多语种识别性能分析

实验结果表明,Zipper-LoRA 在 12 种目标语言上均取得了优异性能。其中,最终版本 Zipper-LoRA-Soft + Initial-B 表现最优,并在 Non-Chunked 设置下于全部12种语言上取得最低错误率。说明所提出的动态参数解耦策略能够在保持跨语言知识共享的同时,有效缓解不同语言之间的参数干扰。尤其是在阿拉伯语、日语和韩语等低资源语言上,相较于 Vanilla-LoRA 分别将错误率从 53.08% 降低至 36.94%、46.28% 降低至 34.04% 和 36.03% 降低至 21.35%,体现了方法在长尾场景下的显著优势。同时,相比 Fully Shared 的 Vanilla-LoRA 和 Fully Decoupled 的 Independent-LoRA,Zipper-LoRA 在所有语言上均取得更加均衡的性能表现,验证了共享与语言特定知识动态融合的有效性。
2、高资源与低资源场景分析

在高资源语言上,仅采用 Rank 级参数解耦的 Zipper-LoRA-Static 即取得了与 Independent-LoRA 相当甚至更优的识别性能,说明共享参数与语言特有参数的解耦设计能够有效缓解跨语言干扰;进一步引入 Hard Routing 和 Soft Routing 后,多数语言的识别性能继续提升,表明动态路由能够根据语言特性自适应地分配共享知识与语言特定知识;最终加入 Initial-B Warm Initialization 后,模型在多个高资源语言上进一步降低了识别错误率,取得整体最优性能。

在低资源语言上,这种渐进式优势更加明显。由于训练数据有限,传统 LoRA 更容易受到高资源语言的负迁移影响,而 Zipper-LoRA 通过动态参数解耦有效缓解了这一问题,在阿拉伯语、日语、韩语和葡萄牙语等语言上均取得了更加稳定的性能提升。其中,Soft + Initial-B 在四种低资源语言上均取得最佳或接近最佳结果,说明该方法不仅能够充分利用跨语言共享知识,还能够有效保留语言特有信息,在长尾数据场景下具有更强的泛化能力。

为了进一步验证 Zipper-LoRA 在不同数据规模下的可扩展性,图7比较了低资源语言从1小时极低资源设置扩展至约30小时训练数据后,各方法相对于 Vanilla-LoRA 的性能变化。结果表明,在 Chunked 和 Non-Chunked 两种配置下,Zipper-LoRA 系列均保持稳定优势,其中在1小时场景下提升最为明显,说明结构化的跨语言知识共享在监督数据极其有限时尤为重要。随着训练数据增加,各方法之间的相对差距有所缩小,但 Zipper-LoRA-Soft + Initial-B 仍保持最佳整体表现,说明该方法不仅适用于极低资源场景,在数据规模扩大后依然具有良好的稳定性和可扩展性。
综合高资源与低资源实验可以发现,Zipper-LoRA-Static → Zipper-LoRA-Hard → Zipper-LoRA-Soft → Zipper-LoRA-Soft + Initial-B 呈现出清晰的渐进式性能提升趋势。这说明本文提出的 参数解耦、动态路由和 Warm Initialization 三项关键设计均能够带来独立贡献,最终形成协同增益,使模型在不同语言资源规模下均保持优异且稳定的识别性能。
3、可视化分析
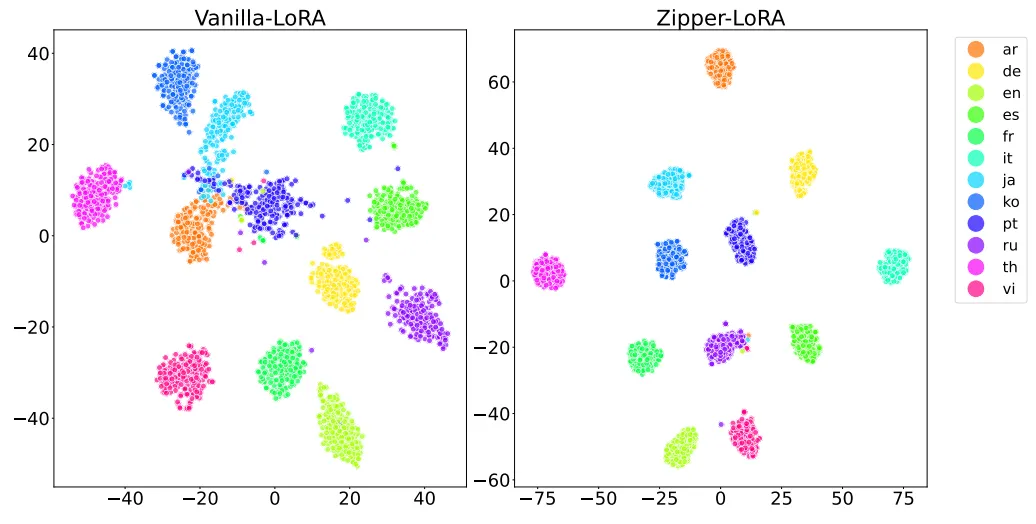
为了进一步分析模型内部表示能力,我们利用 t-SNE 对编码器输出进行可视化,并计算各语言聚类的协方差行列式作为紧凑度指标。实验结果显示,在 12 种语言中的 10 种 上,Zipper-LoRA 的聚类均比 Vanilla-LoRA 更加紧凑,这说明 Zipper-LoRA 能够学习到更加紧凑、判别性更强的语音表示,为其在多语种识别任务中的性能提升提供了进一步解释。
总结
针对 Speech-LLM 在多语种长尾数据场景下存在的跨语言干扰问题,本工作提出了 Zipper-LoRA 动态参数解耦框架,通过 Rank 级共享/语言特有参数解耦、语言感知动态路由以及 Initial-B Warm Initialization 等关键设计,在保持较高参数效率的同时,实现了跨语言知识共享与语言特定建模之间的有效平衡。
实验结果表明,Zipper-LoRA 在 12 种语言、高资源与低资源、Chunked 与 Non-Chunked Encoder 等多种实验设置下均取得了优于现有 LoRA 方法的识别性能。尤其在低资源语言场景下,能够显著缓解跨语言负迁移,同时相比完全独立的 LoRA 方案具有更好的参数效率和可扩展性。进一步的表示空间分析也验证了该方法能够学习更加紧凑、判别性更强的跨语言语音表示。
本工作为 Speech-LLM 多语种参数高效微调提供了一种新的技术思路,可进一步推广至多语种语音识别、语音理解及其他基于大模型的参数高效微调任务,为大规模多语种语音模型的训练与部署提供了新的解决方案。相关成果已被国际期刊 IEEE Transactions on Audio, Speech and Language Processing (TASLP2026) 接收。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。

