今天,阿里正式发布 Qwen-Audio-3.1 系列语音大模型。本次升级不仅对语音识别(ASR)、语音合成(TTS)和实时语音交互(Realtime)三大核心模型进行了全面进化,更重磅推出了全新的音频创作模型 Qwen-Audio-3.1-TTS-Next 和音频理解模型 Qwen-Audio-3.1-ASR-Next。
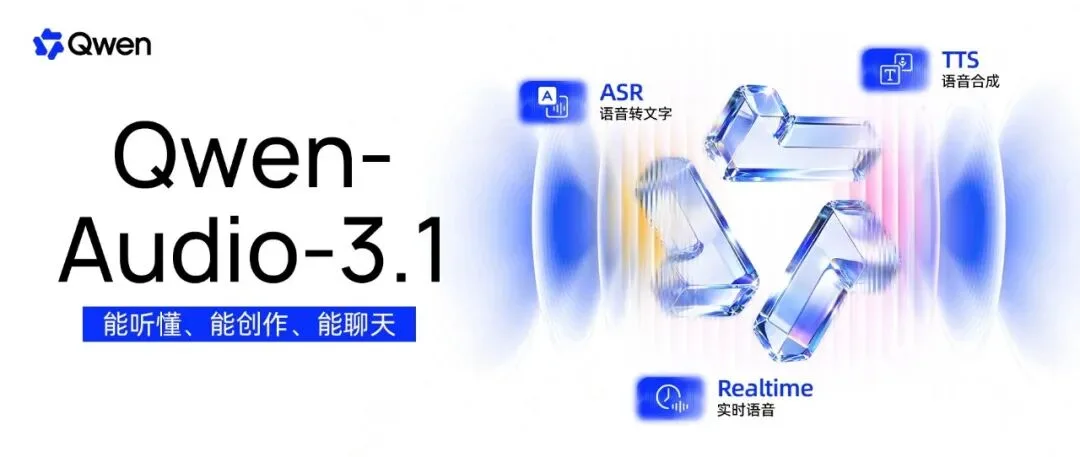

五款全新的语音模型同时推出,形成了一套覆盖“理解-生成-交互-创作”的完整音频能力栈。为进一步降低用户使用成本,Qwen-Audio 全线语音模型价格均下调,其中TTS降价约70%,Realtime降幅约85%,ASR降幅达95%。
目前,Qwen-Audio-3.1 系列模型 API 均已上架千问 AI 平台,体验地址:
- Qwen-Audio-3.1-ASR:
https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
- Qwen-Audio-3.1-TTS:
https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
- Qwen-Audio-3.1-TTS-Next:
https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
- Qwen-Audio-3.1-Realtime:
https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus(Qwen-Audio-3.1-ASR-Next API即将上线)
Qwen-Audio-3.1-ASR:更强的上下文理解和润色
Qwen-Audio-3.1-ASR 是新一代语音识别大模型,进一步增强多语种、方言识别与上下文理解能力,并新增原生转写润色能力,可自动去除语气词与重复表达并重组语义,让转写的文字更顺畅、更有逻辑。
此外,全新方案的分角色转写,完整呈现“谁在什么时候说了什么”,为会议、访谈和对话分析提供可追溯的结构化记录。
核心能力亮点:
- 结构化:端到端方案,把说话人标签、时间戳和文本联合输出。模型既能处理轮流发言,也能保留短插话和重叠语音,把每个人说的话转写清楚。
- 听得广:一套模型支持30种语言和16种中文方言,覆盖多语言交流、方言对话等复杂语音场景。
- 听得准:支持行业词、专业实体和分级热词识别,并能参考长音频历史上下文,让人名、缩写和专业术语保持一致。
- 听得快:支持低延迟流式识别,边说边转写,实时输出准确文字,首字响应约160毫秒。
- 听得清:原生完成去语气词、去重复、自我纠正和语义重组;自动区分不同说话人,实现长音频角色一致、时间对齐与结构化输出。
性能表现
开源方言 ASR/AST:

通过 KeSpeech 和 WSYue 的 11 个子集,评测模型在公开数据上的方言转写与翻译能力。Qwen-Audio-3.1-ASR 平均 CER 为 4.55%,并在 6 个子集上取得最优结果。
中文方言内部自建测试集 ASR:

评测模型对 16 种中文方言的原文转写能力,以字错误率(CER)衡量。Qwen-Audio-3.1-ASR 在 11 个方言子集上取得最优结果,平均 CER 为 10.38%,其中温州话等较难方言的提升尤为明显。
中文方言内部自建测试集 AST:
评测模型将方言语音翻译为普通话、准确保留原意的能力,以语义句准率衡量。Qwen-Audio-3.1-ASR 在 11 个方言子集中的 10 个上表现最优,平均语义句准率达到 82.10%。
Qwen-Audio-3.1-ASR-Next:更好地理解人物情绪与场景
基于下代架构的音频理解模型Qwen-Audio-3.1-ASR-Next全新发布,它能够理解人物情绪、环境声与机械声,完成声音描述、事件定位、音频问答与推理。
例如,面对一段同时包含人物对话、背景音乐和环境声的音频,模型不仅可以输出对话文本,还可以进一步描述音频中包含哪些声音、相关事件在何时发生,并回答与整段内容有关的问题。
由此,ASR 处理的对象开始从“语音中的文字”扩展为“完整的音频信息”。
性能表现
分角色 ASR:

评测多人语音中“谁在什么时候说了什么”的识别能力,同时考察说话人区分和转写准确性。在四个测试集的八项指标中,Qwen-Audio-3.1-ASR-Flash-Next和Qwen-Audio-3.1-ASR-Flash版本分别取得五项和三项最优结果,均全面优于此前的 Fun-ASR 级联系统。
Qwen-Audio-3.1-TTS:更自然的跨语言音色合成
Qwen-Audio-3.1-TTS 是新一代语音合成大模型,支持多语种及方言合成,支持模型在同一音色跨语言合成时的自然迁移,让你秒讲数种语言。
相比只关注字音正确的传统方式,它更强调真实表达:通过指令控制情绪、语速和表达方式,让声音贴近具体内容与使用场景。
Qwen-Audio-3.1-TTS-Next:更高效的音频创作方式
基于下代架构的音频创作模型 Qwen-Audio-3.1-TTS-Next 全新发布。
过去,制作一段完整音频通常需要主播、音效师、混音师和剪辑师分工合作,分别制作人物对白、音效和背景声,再进行后期剪辑与合成。它不再局限于单一语音合成,而是围绕文本、时间戳和参考音频等输入,统一生成人声、音效和环境音,创作完整的音频内容。
核心能力亮点:
- 一个模型统一生成多类音频 :支持生成包含语音及完整环境声场的音频,如一段播客可以同时包含多位说话人的对话与背景音效,一段影视或游戏音频可以包含台词、环境声、动作音和配乐。
- 保持多角色音色与情绪一致 :支持多人音色复刻与多轮对话生成,在连续内容中保持各角色音色特征,并按脚本演绎情绪与节奏,避免多轮生成中角色“变声”,呈现停顿、接话、附和、情绪转折等自然表达。
- 融合人声、音效与环境声:多类声音融合生成,并呈现声音材质、远近变化与空间层次。例如有声书场景中,模型可以同时处理旁白、两位角色的对话,也能生成城市低鸣、晚风和易拉罐碰撞声等音效与环境声,让对话听起来就发生在故事场景里。
- 使用自然语言控制生成过程:通过自然语言指定说话人的语气、语速和音量,描述音乐风格、配器方式以及声音事件的先后顺序。模型还支持细粒度时间戳控制、声音复刻和 48kHz 输出,可对对白起止、声音事件和内容节奏做更具体的安排,满足播客、有声书、影视剧、游戏、广告等专业音频创作需求。
Qwen-Audio-3.1-Realtime:更自然的实时互动体验
实时语音交互,并不是把语音识别、语言模型和语音合成简单串起来。人与人的交流中,说与听常常同时发生:用户可能没说完就补充,也可能在对方回复时插话;同一句话,随情绪、关系和语气不同,含义也不同。
全新升级的Qwen-Audio-3.1-Realtime听得更懂,更会接话,更会共情,甚至可以主动调用 Agent 工具完成任务。全双工实时交互告别了过去模型只能听或只能说的现状,可以做到同时说和听,让用户可以随时插话、打断,交流体验更接近真人通话。
核心能力亮点:
- 从识别文字,到理解情绪与交流意图:模型理解的不仅是语音中的文字,还有声音背后的情绪与意图。识别到用户语气低落时,它不会机械地回一句“我理解你的感受”,而是放慢语速、调整措辞;面对紧张、开心、失落或犹豫,也能结合上下文选择合适的表达。角色扮演场景中,角色设定不只留在 Prompt 里,也体现在连续的声音表达中。
- 支持多语言实时交流与自然切换:对话中切换语言时,模型继续保持此前的上下文、语气和交流节奏,跨语言对话不必因语言变化而重新开始。
- 强化安全边界与事实可靠性:面对不确定信息,减少缺乏事实依据的回答;面对敏感或高风险内容,更准确地识别边界并给出安全回应。它关注的不仅是“能不能回答”,还有何时该谨慎、何时不该给出未经确认的结论。
- 在实时对话中调用工具:当需求涉及外部信息或业务系统时,模型可在对话中调用工具,连接 API、知识库和业务系统完成搜索、查询或任务执行,并把结果自然带回对话。
基于多教师蒸馏架构,模型在保持低延迟的同时,提升了理解、推理、表达与安全能力,所解决的问题也从“如何实时回答用户”扩展为“如何在持续对话中理解变化的需求并完成任务”。
能听懂、能创作、能聊天,Qwen-Audio 3.1 正在让语音成为连接人、内容与 AI 的自然入口。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


