2026 年,围绕神经网络、人工智能和机器学习的热情十分高涨,将其落地到视频编解码器上自然也一直在关注范围内。一些研究表明,在特定测试条件下,端到端学习型编解码器可以媲美甚至超越通用视频编码(VVC)。
联合视频专家团队(JVET)正在就面向未来潜在标准的神经工具开展正式探索实验。但问题在于,其中是否有任何一项应当改变近期的 SoC 路线图。
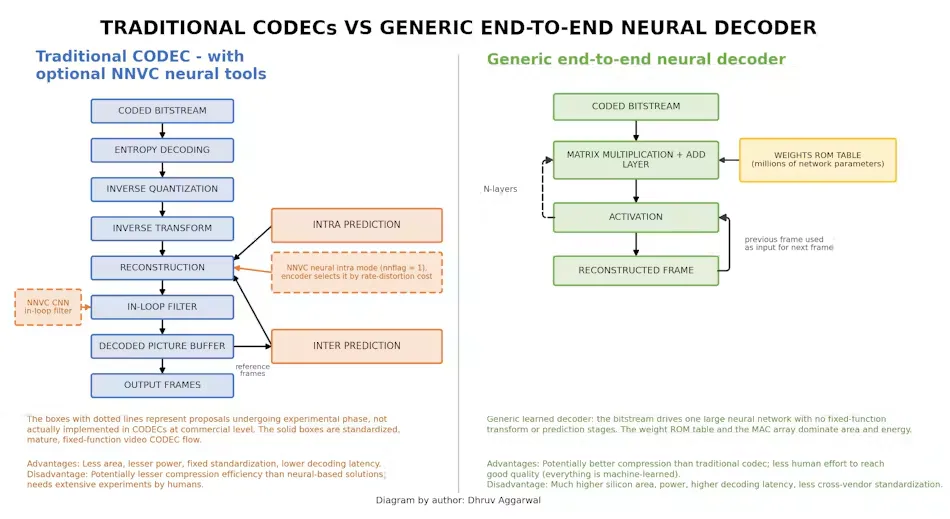
从实际的硬件预算来看,结论是:未来十年内,传统 VVC 不会被挤出消费级芯片。基于神经网络的视频编码或许在算法端正在取胜,却在芯片底线上落败。在相同节点下,端到端神经解码器的每像素能耗硬件成本大约比成熟 VVC 芯片差一个数量级,而且全神经编解码器尚无标准可用。混合方案即把 JVET 的基于神经网络的视频编码(NNVC)帧内预测加到 VVC 核心之上,硬件成本更低,但仍然相当可观。只有在未来标准正式批准该方案时,它才在高端消费级 ASIC 中具备可行性(图 1)。

- VVC(H.266)是 HEVC(H.265)的继任者,在同等视觉质量下可带来约 40–50% 的码率降低。
为什么要探索神经编解码器
从 H.264 到 HEVC 再到 VVC,每一代都在前代基础上带来约 30–50% 的码率降低,但维持这一轨迹正变得越来越昂贵。在全帧内(all-intra)编码中,以参考软件运行时间(VTM 对 HM)衡量,VVC 参考编码器的复杂度已是 HEVC 的约31 倍,驱动因素是每一代预测模式数量的持续增长:仅角度帧内模式一项,就从 H.264 的 8 个增至 HEVC 的 33 个,再到 VVC 的 65 个。然而,要靠人工设计编码工具在压缩上取得显著提升,每一代都比上一代更难。
神经视频编码正是在这一背景下出现的。其吸引力在于,学习型工具能够捕捉人工设计算法无法捕捉的压缩效率与感知质量,而增益来自训练与数据,而非再花费十年打磨手工编码工具。JVET 的 NNVC 探索已将两个神经工具纳入其参考软件(尚未进入规范性标准):一个全连接帧内预测模式和一个卷积环路滤波器,在各配置下合计约带来 10–12% 的 Y BD-rate 增益。
NN 帧内预测模式通过 nnFlag 按块信令指示,并与现有的 67 种帧内模式、MIP、ISP、MRL 和 CCLM 通过率失真优化竞争,而不是取代它们。端到端神经编解码器(DCVC-FM、NVRC)在特定测试配置下(例如 UVG 上的单 I 帧或随机接入)可match或超过 VVC:NVRC 在 UVG 上以 24% 的 BD-rate 优于 VVC,DCVC 系列编解码器在多项质量指标下能生成主观上比 VVC 更平滑的低码率图像。问题出现在需要把这些结果塞进手机(散热/功耗预算,并需与其他 AI 工作负载多任务并行)、电视(标准化挑战、成本敏感、能源之星评级)或车载信息娱乐系统(功能安全验证成本、NPU 与其他安全关键操作的争用)这类消费设备的时候。
芯片的实际成本
传统 VVC 硬件解码器效率极高。量产 IP 核已可实现 8K 解码。关于完整解码器能效,最接近的公开锚点是 Tikekar 等人基于台积电 40 nm 工艺的 HEVC 解码器 ASIC,其 4K30 实测为每像素 1.19 nJ。按历史上从 40nm 到 28nm 每节点 30–50% 的功耗下降幅度外推,并计入约 1.6–1.8 倍的 HEVC→VVC 复杂度提升,一颗 28 nm 的 4K60 VVC 解码器大致可落在每像素 1–1.5 nJ、约 100 万门以内的水平。量产 VVC IP 的具体数据属专有信息,并未直接公开。
唯一已发表的端到端神经解码器 ASIC(NVCA)是最干净的数据点。它采用台积电 28 nm 综合,501 万门(不含存放在片外的权重 ROM),可实现 1080p25、760 mW,折算下来约为每像素 14.6 nJ。其功耗与面积数字,比同节点的传统 VVC 高出数个数量级。
混合方案(JVET 的 NNVC 实验)所面临的硬件挑战比 NVCA 少,但也并非没有代价。NNVC 神经帧内预测规定了 7 个全连接网络(对应 4×4 到 16×16 的每种受支持块形状各一个),每层约 1216 个神经元,大约会在 30–40% 的帧内块上被调用。如果标准批准 NNVC,实际的硬件路径是一套共享 MAC 阵列,对 7 组与块形状相关的权重集做时分复用——在每次块级推理开始时把对应的权重集载入阵列,并在计算期间保持其静态驻留。
权重将存放在片上 ROM 中,类似于 VVC 的 MIP 与 LFNST 系数。NNVC 帧内预测会在严格的延迟周期预算下给 VVC 解码器流水线增加计算负载,因为基于 NN 的解码生成一个输出所需的周期数远多于传统算法。新增的面积、功耗与验证成本并不小。一旦该工具完成标准化,这些成本在高端 SoC 上是可以站住脚的;但在成本敏感型芯片上很难自圆其说,毕竟 10–12% 的 BD-rate 增益无法收回芯片成本。
标准化同样是决定性因素。最终 NNVC 解码器的比特精确定点推理必须在各设备间保持一致。这一约束排除了许多标准的 NPU 效率技术,例如降低精度推理和算子融合。VVC 已作为 ITU-T H.266 定稿,并具备成熟的许可体系。NNVC 仍处于 JVET 的探索阶段。端到端神经编解码器则更靠后:没有已批准的标准、没有跨厂商互操作性、也没有可用于构建产品的专利许可框架。这对合规性属强制要求的消费级硬件而言是个问题。
解决方案:分层部署,而非整体替换
让传统 VVC 继续作为主通路。在未来五到七年内,VVC(或 AV1)解码器模块仍是正确选择。它成熟、行为确定,并在所有相关节点上都有支持;而 VVC 内容在该标准 2020 年定稿后的二十年内都会被解码。为了神经编解码器而跳过它是误判。
在标准化与预算允许时,把 NNVC 工具作为辅助模块加入。将一个小型 NN 推理模块与 VVC 解码器耦合,为规范性权重集预留 ROM、为工作存储预留 SRAM,比特精确地对齐 SADL,并为可观的验证工作量做好预算。
通用型端到端神经解码器模块,在未来几代 SoC 中都不应进入消费级芯片。硬件成本过高、标准尚不存在、生态也不支持。端到端神经编解码器可能在 VR/AR、机器视觉以及与硬件协同设计的边缘编码等特殊场景中有限度使用。
对流片意味着什么
对芯片架构师而言,指引很具体:不要为了追逐神经编解码器而跳过 VVC 硬件支持,也不要为不会如期到来的采用率而过度配置 NPU 容量。规划分层部署,把任何神经工具的采用与标准化时间表绑定,让流片反映真实存在的世界。在这里,更保守的芯片才是正确选择。那种戏剧性的替代叙事,即便最终可行,也需要数十年才能成为现实。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/72937.html
