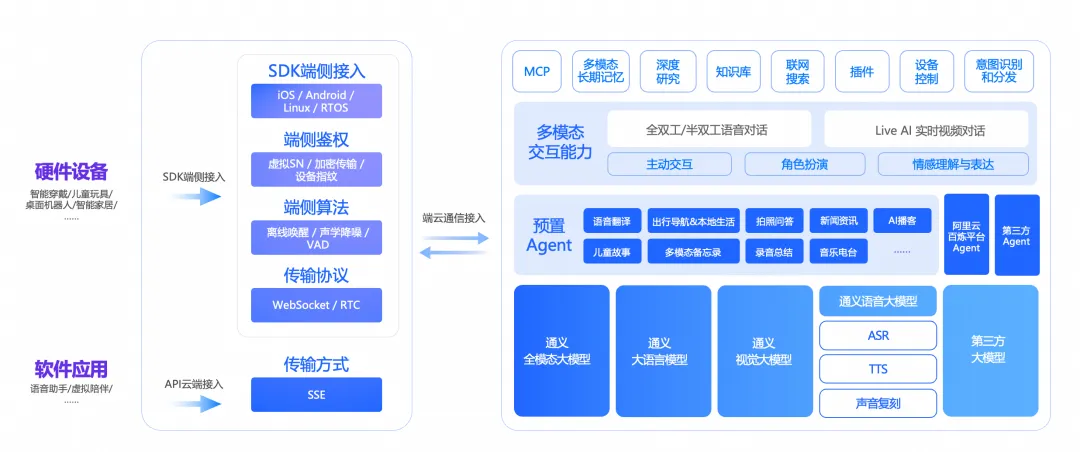
百炼多模态实时交互开发套件,能为 AI/AR 眼镜、学习机、汽车、智能机器人等设备注入「听懂、看懂、会思考」的智能能力。借助自然对话、多模态感知与实时交互,设备可以成为硬件 Agent,服务于聊天对话、文物讲解、作业辅导、花艺推荐、健康管理等场景,让智能融入日常生活。

设想用户对着智能设备说出一个产品型号:设备要听准名称、完成查询,再及时给出自然的语音回复。要把这样的体验做进产品,开发者需要衔接好语音输入、业务处理与语音反馈三个环节。
此次,百炼多模态交互套件(Agent Studio for Hardware)升级 Qwen-Audio-3.1 语音大模型,聚焦低延时流式 ASR(自动语音识别)的感知能力与流式 TTS(语音合成)的生成能力:更准确的语音转写,为下游模型理解用户意图、提取工具参数提供更可靠的输入;工具返回结果后,更快、更拟人的语音反馈让交互衔接更自然。
实时语音交互的不同技术路径,近期受到业界越来越多的关注。Google 发布 Gemini 3.8 Live 系列,采用原生语音到语音能力,支持实时视觉输入与异步工具调用;OpenAI 的 GPT-Live 支持全双工实时听说,可将推理与工具调用交给后台 Agent,在任务处理期间持续与用户对话。阿里巴巴全新升级的Qwen-Audio-3.1-Realtime 端到端模型听得更懂,更会接话与共情,也可以主动调用工具完成任务。
实时语音交互存在不同的系统组织方式。其中,端到端语音模型将音频理解与语音生成更紧密地结合;级联式方案则把语音识别、大模型理解与业务处理、语音合成拆分为独立环节,让开发者可以逐环节选择、检查和调优。此次升级面向百炼套件的级联式交互方案:开发者围绕业务配置模型与流程,同时获得 ASR 感知与 TTS 生成两端的能力提升。
ASR 升级让设备接住更多语言与专业表达
Qwen-Audio-3.1-ASR 支持 30 种语言和 16 种中文方言,覆盖多语言交流、方言对话等场景。面向不同地区用户的设备,可在此基础上验证目标语言与方言的实际识别效果。
在专业场景中,人名、产品名和缩写往往比普通词汇更影响后续理解。此次升级支持行业词、专业实体与分级热词识别,并可参考长音频的历史上下文,提升专有名词的识别效果和前后表述的一致性。在工具调用场景中,准确转写这些信息,有助于减少输入端的识别偏差,为下游意图理解和参数提取提供更可靠的依据。开发者可以用自己的业务词表来验证,例如设备助手中的产品型号与功能名称。
实时性方面,模型支持低延迟流式识别,边说边转写,首字响应约 160 毫秒。该指标衡量 ASR 首次输出识别文字的响应速度,不含后续业务处理与语音合成耗时。
此次 API 还支持近场与远场语音能力的自定义切换,可灵活适配不同设备的拾音场景。
在基于 KeSpeech 和 WSYue 共 11 个子集的方言转写与翻译评测中,Qwen-Audio-3.1-ASR 的平均字错误率(CER)为 4.55%,并在 6 个子集上取得最优结果。
TTS 升级让同一个声音拥有更丰富的表达
Qwen-Audio-3.1-TTS 支持多语种及方言合成,可在所支持的音色与语言范围内,用同一音色完成跨语言、跨方言表达。具体可用范围因音色而异,接入时请以官方音色列表为准。
表达控制更灵活,声音就能更贴合内容与场景。开发者可通过自然语言指令调节情绪、语速和表达方式:儿童故事用更活泼的讲述方式,展品介绍用平稳清晰的语气,操作步骤适当放慢语速,围绕产品角色调试出合适的声音体验。
在工具执行后的反馈环节,TTS 能更快地把回复文本转为语音,让交互衔接更自然。对于提供多语言服务的设备,同一音色的跨语言表达也有助于保持角色声音一致。实际效果建议结合目标文本、音色和语言试听确认。

9 月 28 日,在全球权威 AI 评测平台 Artificial Analysis 的语音排行榜(Controlled Voice Arena)上,Qwen-Audio-3.1-TTS 以 1177 的 Elo 评分位列全球第一。
级联架构为开发者提供更灵活的定制空间
对于需要自选业务模型、复用已有流程并精细调整声音的开发者,级联式方案提供了更直接的定制入口。套件支持分别选择语音识别、文本生成与语音合成模型,并配置提示词、知识库、技能和 Agent,团队可在平台支持的范围内组合出适合产品的能力。
具体来说,输入端可围绕行业词与产品型号配置识别热词;业务处理环节可选择大模型、设置角色与回复规则、衔接已有工具及工作流;输出端可选择音色,并调试语速、情绪与表达方式。识别结果与待播报文本这两个中间节点,也便于开发者检查结果、定位问题。对于强调分环节控制与持续迭代的应用,这种组织方式更便于定制。
以设备信息查询为例:用户说出产品型号,ASR 将语音转成文字,下游模型理解需求、提取参数,业务工具完成查询,生成的回复文本再交给 TTS 播报。此次升级聚焦这条链路两端的 ASR 与 TTS,业务理解和工具执行仍由所配置的大模型、Agent 及业务工具完成。
在套件层面,语音对话端到端延迟最低为 1 秒,视频对话延迟低至 1.5 秒,并支持随时打断。需要说明的是,这里的“端到端延迟”是交互链路的响应延迟指标,既不同于“端到端模型架构”,也不同于前文的 ASR 首字响应。实际表现受网络、设备、所选模型与业务配置影响,工具执行耗时需另行评估。套件还可组合视觉理解等能力,构建多模态体验。
接入层面,套件以一套 SDK 覆盖 Android、iOS、Linux、RTOS,已适配 30 多个主流硬件平台,减少跨平台的重复对接。针对穿戴设备、玩具、学习机、智能家居和 IPC(网络摄像机)五类设备,套件提供预置品类方案,常用能力与音色已预先配置,开发者可在此基础上继续打磨产品体验。
降低语音调用成本并支持后续设备运营
按本次升级的对比口径,相较上一代语音模型,TTS 价格降低约 70%,ASR 价格降幅达 95%。这两项降幅仅针对语音模型;整条交互链路的费用还需计入大模型对话及其他实际调用的能力。具体模型型号、地域、计费方式与价格,以控制台和官方计费说明为准。
对需要长期运行的硬件产品而言,样机验证之后还有设备管理与服务运营。套件提供托管运行、设备群管理、计量计费和可观测能力,支撑从原型验证到规模部署,帮助团队持续掌握设备运行情况与实际用量。
从一个具体场景开始构建硬件 Agent
阿里云百炼 Agent Studio for Hardware 支持工作流和对话式开发,可用于搭建与调试硬件应用。建议先选一条已有的查询或控制流程,用业务词汇测试语音识别,再对执行结果的语音回复进行试听和调优。
验证时,使用目标用户的真实语言,在计划采用的硬件和网络环境中,分别观察语音识别、业务执行和结果播报的表现,并结合交互频次估算费用。借助级联方案的分环节配置,根据测量结果调整对应的模型与参数,逐步优化产品体验。
现在就前往 Agent Studio for Hardware,选择适合的设备方案,开始构建你的硬件 Agent。
相关资料参考:
[1] Google Gemini 实时语音模型:https://blog.google/innovation-and-ai/technology/developers-tools/build-real-time-voice-applications-gemini-audio/
[2] OpenAI GPT-Live 实时语音交互:https://developers.openai.com/api/docs/guides/live
[3] OpenAI 语音 Agent 架构与级联式工作流:https://developers.openai.com/api/docs/guides/voice-agents
[4] Qwen-Audio-TTS 音色列表:https://help.aliyun.com/zh/model-studio/qwen-audio-tts-voice-list
[5] 多模态交互应用配置:https://help.aliyun.com/zh/model-studio/multimodal-app-configuration
[6] 多模态交互开发套件产品:https://help.aliyun.com/zh/model-studio/multimodal-products-overview
[7] 阿里云多模态交互开发套件计费说明:https://help.aliyun.com/zh/model-studio/product-billing
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


