产品评审结束后,项目负责人要交付一份能继续推进工作的纪要:哪些方案已经达成共识,哪些问题还需拍板,各方的理由分别是什么。这些答案往往散落在整场讨论里,拿到逐字稿之后,还要把它们重新整理出来。
在客户服务的场景,用户带着地方口音,能否被准确识别?内容团队关心的则是如何根据台词设计出在情绪、节奏、风格等维度全面契合角色的语音?
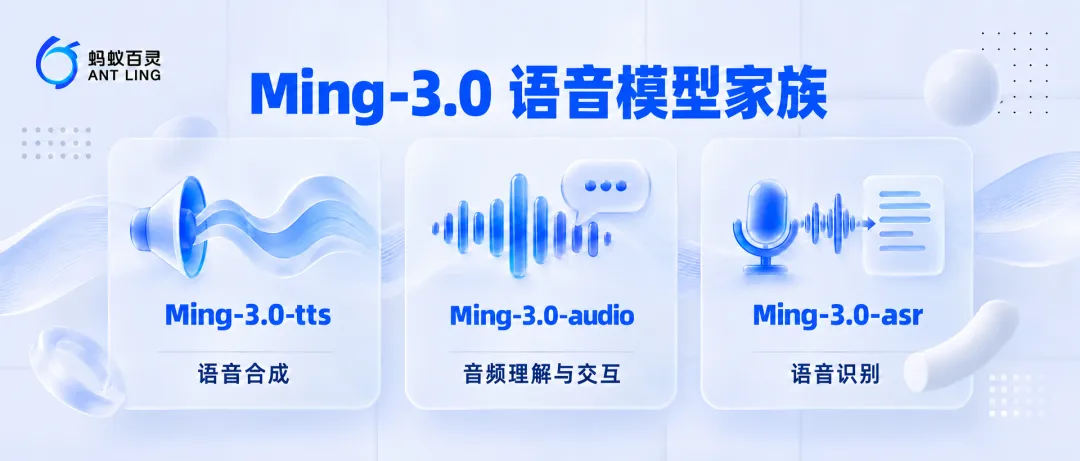
围绕声音创作、长语音分析、业务语音转写三类任务,蚂蚁百灵开源 Ming-3.0 语音系列,分别提供语音合成、音频理解与对话、语音识别三个系列,共五款模型。开发者可以按任务选择,也可以将不同能力组合进自己的工作流。


有声内容与产品助手:Ming-3.0-tts 按角色设定调整声音
Ming-3.0-tts 系列的 Voice Design 可以用文字描述目标音色,同时也支持参考音频的音色设定。更具特色的是,创作者可以用导演模式说明台词的表演方式,描述情绪如何变化、哪些词需要重读,以及节奏应如何处理。
在蚂蚁,从阿福 APP 的主对话与语音通话,到医生音色克隆、小虎智能办公,Ming-3.0-tts 已进入多类业务。它既可以独立承担配音,也可以与 Ming-3.0-asr-tiny 组合,连接语音输入和回答播报两个环节。
给台词加个导演:调整情绪、节奏与重音
无论是突如其来的惊讶,还是隐忍克制的怒意,只需用文字描述演绎方式,就能让声音呈现细腻的情绪变化。
用笑声和叹息表现人物状态
一句台词前的叹息,或说到一半时的一声轻笑,可以帮助听众理解人物的状态。TTS 系列支持在文本中放入行内副语言标签,指定笑声、叹息、咳嗽等表达出现的位置。
0.5B 小参数获得出众效果
在 Artificial Analysis 2026 年 10 月的评测中,Pronunciation Robustness 测试关注专有名词、缩写、数字等内容能否读准,Ming-3.0-tts-0.5B得分为 93.2%,并列全榜单第 1,在 Controlled Voice 榜单中以 1069 Elo 位列开放权重模型第 1。Provider Voices 中以 1188 Elo 位列开放权重模型第 3。
会议与访谈:Ming-3.0-audio 从长录音中整理共识与分歧
Ming-3.0-audio-flash/tiny 支持直接对长音频的转写、总结和观点分析等复杂理解,并进行结构化输出。相对传统的先语音识别逐字稿再分析的过程,能保留对话中的情绪、说话人身份、环境信息等,这需要模型首先要对长音频有高效的语音表征,同时保留声音中的人声、音频事件、环境音等的精细声学信息,另外还需要模型对长上下文序列的快速推理。
Ming-3.0-audio-flash/tiny 支持直接对长音频的转写、总结和观点分析等复杂理解,并进行结构化输出。相对传统的先语音识别逐字稿再分析的过程,能保留对话中的情绪、说话人身份、环境信息等,这需要模型首先要对长音频有高效的语音表征,同时保留声音中的人声、音频事件、环境音等的精细声学信息,另外还需要模型对长上下文序列的快速推理。
模型架构设计让长音频理解与交互更高效
一场录音越长,连续提问需要处理的声音信息就越多。Ming-3.0-audio-flash 在输入端采用 6.25 Hz 低帧率音频表征,缩短同等时长录音对应的序列;语言主干基于 Ling-3.0,结合 KDA 与 Gated MLA 混合注意力和稀疏 MoE 架构,降低长音频理解与回答的计算负担。
听懂录音、推理与调用工具,支撑更完整的语音任务
从理解声音与说话内容,到语音推理和工具调用,评测覆盖了不同任务。
- Ming-3.0-audio-flash 在综合音频理解评测 MMAU 和语音问答与指令遵循评测 VoiceBench 上分别得分 82.00、86.74。
- 在语音推理评测 BigBenchAudio 上(S2T),Ming-3.0-audio-flash 得分 99.40,位列图示模型第一;在语音工具调用评测 SpeechFCEval 上得分 82.60。

客户沟通与语音输入:Ming-3.0-asr 准确识别口音、地名与专业术语
方言口音理解、热词识别、对话上下文信息注入等是语音识别领域的传统难题,也是 ASR 模型在实际业务落地中的高价值问题。MIng-3.0-asr-tiny 通过构建普通话、英文、方言、领域热词等高质量语料,合理控制分布,再结合语言模型基座强大的上下文理解能力,利用候选热词列表、对话上下文信息,为真实业务场景带来语音识别效果的全面提升。
热词与上文:把场景信息一起交给模型
Context ASR 可以在识别时接收两类场景信息:热词列表提示可能出现的产品名、人名、地名和行业术语;对话上文帮助模型理解连续交流中的语境。应用可按需传入这些信息,辅助判断同音词和不常见的名称,无需为此额外训练模型。在蚂蚁,Ming-3.0-asr-tiny 已用于阿福医生助手、支付宝搜索、蚁小保实时语音对话和安全核身等场景。
在领域热词、方言识别、中英文语音识别等四类评测中,Ming-3.0-asr-tiny (8.6B A2B)的平均错误率为 4.41%。与闭源模型 Fun-ASR 1.5,以及开源模型 FireRedASR2-LLM(8B)、Qwen3-ASR-1.7B 相比,识别准确率进一步提升。
局限性与未来计划
面向下一步,我们将重点探索语音交互在真实复杂场景的应用:
- 让语音交互支持长程复杂任务:探索 Voice Agent,让语音成为发起和持续推进复杂任务的交互入口。通过多轮对话理解需求、发起任务、查询进展,并记住相关上下文与用户偏好,支持任务在持续交互中逐步完成。
即刻体验 Ming-3.0 系列语音模型
在线体验入口:https://ling.tbox.cn
- 在线体验:访问 Ling Studio Chat,选择 Ming-3.0-audio-flash,体验音频理解与对话能力。
- API 调用:Ling Studio 提供 Ming-3.0-tts-0.5B、Ming-3.0-audio-flash 和 Ming-3.0-asr-tiny 的 API 服务,开发者可将语音识别与语音生成接入自己的业务工作流。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。

