好久不见,最近整理了读者反馈的几个图形渲染岗位的技术面试问题。这几个问题出现的频率很高,而且容易被连环追问,今天挑出来讲讲。
现如今顶级 AI 的编程能力上已经超过 99.99% 程序员,但是从最近刚入职的一些读者的反馈来看,技术面试中八股文依然占有重要的权重。而面试官判断「背过」还是「做过」,往往就靠这类工程细节。
1. 大图纹理跨 JNI 传递,如何避免拷贝?
这是个好问题,考察平时开发中有没有刨根问底的好奇心。
常规做法是把 Java 层 Bitmap 的像素取出来,经 jbyteArray 或 ByteBuffer 传到 native,再交给 glTexImage2D。一张 4K RGBA 图约 32 MB,这条链路上通常发生三次拷贝:
Bitmap.getPixels把像素复制进 Java 数组;GetByteArrayElements不保证返回直接指针,可能再复制一份并在ReleaseByteArrayElements时写回;glTexImage2D由驱动上传至 GPU。
大图卡顿的根因往往不是 JNI 调用本身,而是这三份中间副本。
第一层优化是取得直接指针。Android 8.0 起 Bitmap 的像素默认分配在 native heap,可用 jnigraphics 的 AndroidBitmap_lockPixels 拿到像素首地址,直接作为 glTexImage2D 的数据源,上传后立即 AndroidBitmap_unlockPixels;传 ByteBuffer.allocateDirect 时用 GetDirectBufferAddress 同理。此路径只保留 GPU 上传这一次拷贝,已能消除绝大多数大图传递开销。
第二层是彻底免上传。若源本身就是 GPU 可采样的图形缓冲,可用 eglGetNativeClientBufferANDROID 从 AHardwareBuffer 取得 EGLClientBuffer,以 EGL_NATIVE_BUFFER_ANDROID 为 target 调用 eglCreateImageKHR,再用 glEGLImageTargetTexture2DOES 绑定为纹理;
Skia 侧也有直接从 AHardwareBuffer 构造 SkImage 的工厂。此时像素自始至终留在 Gralloc 缓冲里,CPU 侧零拷贝,连 glTexImage2D 都不需要。
2. 什么是 OES 纹理,为什么相机和视频链路常用它?
GL_TEXTURE_EXTERNAL_OES 不是一种像素格式,而是一块由外部生产者写入的图形缓冲在 GLES 里的只读视图,配套 GL_OES_EGL_image_external 扩展与 shader 中的 samplerExternalOES。
不能直接用 GL_TEXTURE_2D 的原因是,底层 GraphicBuffer 可能是 YUV 多平面、厂商私有 layout 或带特殊 stride 与对齐,普通 2D 采样器无法解读;
外部纹理把格式适配交给驱动,在采样时完成 YUV→RGB 转换与 layout 处理,应用只需写 shader。
标准链路是:Camera2 或 MediaCodec 输出到应用提供的 Surface → 该 Surface 的 BufferQueue 由 SurfaceTexture 消费 → 包装成 GL_TEXTURE_EXTERNAL_OES → GLES 采样绘制。
调用 updateTexImage() 把队列中的最新帧绑定到纹理,用 getTransformMatrix() 取出的矩阵修正方向与裁剪;
像素自始至终留在 Gralloc 缓冲中,不经过 CPU 回读或 memcpy,这正是相机预览与视频滤镜能做到低延迟的原因。
3. 双线性插值为什么还会出现摩尔纹?
这个问题有点奇怪?到底是问双线性采样还是摩尔纹出现的原因?索性一起回答得了。
L_LINEAR 取采样点周围 4 个纹素做加权平均,本质是点采样加一个 2×2 的小范围低通;它解决的是放大时一个屏幕像素覆盖不足一个纹素所产生的锯齿,让边缘平滑。
双线性采样跟摩尔纹没关系,「开了双线性就不会有摩尔纹」是最常见的错误结论,两者不在同一个维度。
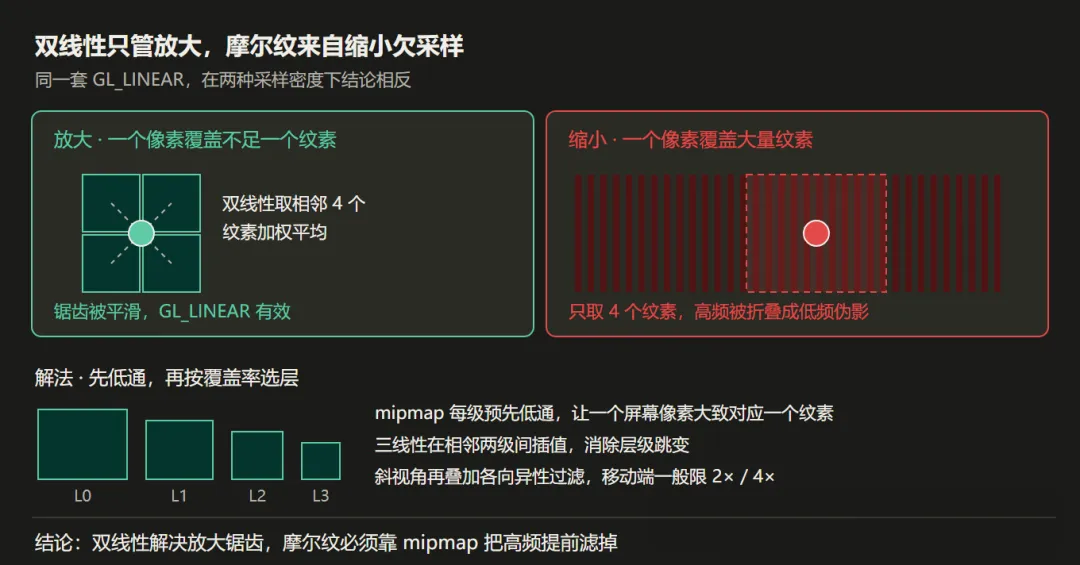

摩尔纹来自相反的情形:缩小时一个屏幕像素覆盖了大量纹素,双线性仍只取其中 4 个,等价于对高频信号做点采样,违反奈奎斯特采样定理,高频被折叠成低频伪影,表现为细密条纹、闪烁与爬行。
进技术交流群,扫码添加我的微信:Byte-Flow
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/73103.html


