在一场跨国视频会议里,一位同事正在用中文介绍方案。
他说:
我们准备先在几个城市灰度,观察一周以后——
他还在继续说,屏幕另一端的英文翻译已经开始播放:
We plan to roll it out gradually in several cities and monitor it for a week before…
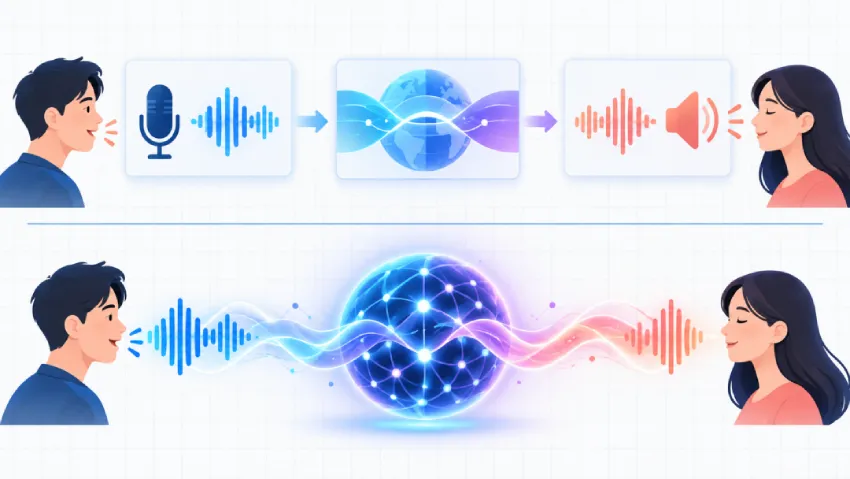
说话人还没有讲完整句话,AI 已经开始用另一种语言替他说话。这就是语音到语音同传。它看起来像“给语音加一个翻译功能”,但真正困难的地方并不是把一句中文翻成英文,而是要在一句话尚未结束时,一边听、一边理解、一边翻译,还要尽快用自然的声音说出来。
同传不是等一句话说完再翻译,而是在信息不断到来的过程中,持续决定哪些内容可以先说、哪些内容还需要等待。
传统语音翻译,像一条接力流水线
传统语音到语音翻译的一种常见方案,通常由三个系统串联完成:
- ASR 把源语言语音识别成文字;
- 机器翻译把文字转换成目标语言;
- TTS 再把译文合成为语音。
例如,用户说:
这个版本先不要全量上线,我们再观察一周。
系统先识别出中文文本,再翻译成:
Do not fully launch this version yet. Let’s monitor it for another week.
最后由语音合成系统把英文读出来。
这条路线清晰、成熟,也便于分别优化每个模块。但它有一个天然问题:前面的错误可能传递到后面,影响最终结果。
如果 ASR 把“不要全量上线”听成“要全量上线”,翻译系统可能忠实地翻译这个错误,TTS 还会用非常自然、自信的声音把它说出来。
最终用户听到的结果很流畅,却完全说反了。
除了误差传递,如果模块之间只传递文字,传统流水线还容易丢掉声音里的信息。说话人的停顿、强调、疑问、犹豫和情绪,很难仅靠识别文本完整保留。文字再被合成为语音时,意思也许保留了,但“这个人是怎么说的”未必能得到还原。

同传最难的问题:什么时候可以开口
非同传的翻译系统可以等一句话说完,看清完整上下文后再组织译文。
但同传不能一直等。
如果说话人讲完十几秒,系统才开始播放翻译,交流会变成轮流等待;但如果系统听到几个词就立刻翻译,又可能因为上下文不足而做出错误判断。
例如:
这个方案我们不是不能做,但是……
只听到“这个方案我们不是不能做”,系统可能开始翻译成:
It’s not that we can’t do this…
但说话人接下来可能说:
但是当前成本太高,我们决定暂停。
前面的译文本身没有错,后面仍然可以自然接上:“…but the cost is too high at the moment, so we’ve decided to put it on hold.”
问题在于,如果系统过早把“不是不能做”简化成“我们会做”,就把尚未明确的态度翻成了确定的承诺。同传需要及时表达已经明确的信息,同时保留原话中的限定和转折空间。不同语言的语序还会放大这个问题。有些信息在源语言里很早出现,在目标语言里却应该放到后面;有些关键动词直到句尾才出现。系统如果过早开口,后面可能很难自然地把话圆回来。
因此,同传系统始终在做一个取舍:
- 多等一会儿,可以获得更完整的上下文;
- 少等一会儿,可以让交流更实时;
- 说得太早,容易翻错;
- 说得太晚,又失去了“同传”的意义。
这类策略常被概括为“读多少、写多少”,放在语音到语音场景里,则是:听到多少信息以后,系统才有把握在另一种语言里开口。
等待更多输入有助于消除歧义,却也会推迟开口。同传的难点,就在于随着信息不断到来,持续把握输出的时机。
不只要翻对,还要说得像一句话
文字翻译的结果可以回看、修改和重读,语音却是沿着时间发生的。
一段合格的同传语音,不能只是把译文快速念出来。它还要处理停顿、重音、节奏和语气。
例如,同一句“真的吗”,可能表达惊讶、怀疑、开心,也可能是礼貌性的确认。如果翻译只保留字面意思,目标语言中的声音始终平稳、机械,说话人的真实态度就可能丢失。
更进一步,用户可能希望译文保留自己的声音特征,让对方听起来仍然是在与“这个人”交流,而不是每个人都被替换成同一个播音腔。
这意味着系统传递的内容至少有三个层次:
- 语义:说话人表达了什么;
- 表达:这句话是疑问、强调、犹豫还是肯定;
- 身份特征:是谁在说话,声音具有怎样的音色和风格。
表达和声音特征的保留也需要控制边界。情绪迁移错误可能改变一句话的态度;声音复刻还涉及授权、隐私和滥用问题。
因此,“像本人”并不总是越像越好。一个可靠的产品需要明确区分内容翻译、表达风格迁移和声音复刻,并为后两者设置清晰的授权边界。
怎么评价一套同传系统
只看译文是否准确,无法完整评价语音到语音同传。
至少还需要关注几个方面:
- 语义准确性:有没有漏译、错译,否定、数字、人名和专业术语是否正确;
- 延迟:说话人与翻译声音之间相差多长时间;
- 增量稳定性:已经播放或展示的结果是否频繁改变;
- 语音自然度:目标语音是否连贯,停顿和节奏是否合理;
- 表达保持:疑问、强调和情绪是否在翻译后得到适当保留;
- 鲁棒性:遇到噪声、口音、方言、中英混说和多人插话时是否仍然可靠。
这些指标之间还会互相冲突。
等待更长时间通常能提高翻译准确性,却会增加延迟;为了快速开口而频繁生成短片段,又可能让语音变得断断续续。保留原说话人的语气可以增强交流感,但如果模型理解错了情绪,也可能把普通陈述说成质问。
因此,真正的评价标准不是某一个分数,而是系统能否在准确、实时和自然之间找到适合具体场景的平衡。
国际会议更关注术语准确和多人连续交流;旅行对话更关注响应速度;允许缓冲的直播翻译或视频译配场景,则可以适当增加等待时间,换取更自然、更完整的表达。
从三级流水线到更统一的模型
语音到语音翻译正在从传统级联系统,逐渐走向更统一的建模方式。
一种路线仍然保留 ASR、翻译和 TTS 三个模块,但让它们以流式方式协同工作:ASR 持续输出稳定片段,翻译系统增量生成译文,TTS 根据已确认内容快速开口。
它的优点是结构清楚,每一层都可以单独检查。出现问题时,也比较容易判断究竟是听错了、翻错了,还是说得不自然。
另一种路线则尝试减少文字这个中间瓶颈。模型直接理解源语音中的语义和表达信息,再生成目标语言语音。文字仍然可以作为训练信号或辅助输出,但不再是所有信息必须经过的唯一通道。
这种方式有机会更好地保留语调、情绪和说话风格,也能减少多个模块反复等待带来的延迟。但系统越统一,错误就越难拆解:当译文不对时,我们需要知道模型是没听清、没理解、翻错了,还是语音生成阶段表达出了问题。
因此,两条路线并不是简单的新旧替代。
级联系统更容易控制、审计和修正;端到端系统则为更低延迟、更自然表达和更完整的语音信息保留提供了可能。真实产品也可能把两者组合起来:统一模型负责实时生成,文字转写和独立翻译模块负责校验、字幕与追溯。
更大的图景
语音到语音同传改变的不只是翻译的输入和输出形式。
需要整句等待的语音翻译更像一个工具:说完一句,等待处理,再播放结果。真正实时的语音到语音翻译,则有机会成为交流本身的一部分。当延迟足够低,系统不再打断对话节奏;当语义足够可靠,人们不必不断回看字幕确认;当语气和表达得到保留,交流也不再只是信息搬运。
当然,语言之间并不存在完全无损的转换。文化背景、双关、幽默、礼貌程度和说话人的含蓄表达,都可能无法被简单映射。一个成熟的系统不仅要学会流畅地翻译,也要学会在不确定时保守一些,在关键信息上留下文字和时间锚点,让结果可以回看和核对。
理想的语音到语音同传,不是让人忘记语言存在差异,而是让这种差异不再频繁打断交流。说话人仍然使用自己最熟悉的语言。而对面的人,不必等他讲完整句话,就能开始听懂他正在表达的意思。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


