复用一套 Flutter 业务与语音调用代码,为 Android、iOS 和鸿蒙三端应用加入语音转写、内容播报和对话助手。
百炼语音模型 Flutter SDK 用统一的 Dart 接口连接原生语音能力,并内置 Android、iOS、HarmonyOS 三端桥接。团队可以围绕共用的 Flutter 页面、业务逻辑和语音调用方式,为上述三个平台快速接入语音识别、语音合成与语音对话大模型。从会议转写、内容播报到语音助手,共用的上层代码有助于减少各平台的重复开发,让团队将更多精力投入交互体验和业务集成。
在移动端接入生态中选择适合应用的语音接入路径
移动端语音集成目前已有原生语音 SDK、跨端会话 SDK 和协议接入等多种路径,海外与国内都出现了面向 Flutter 的官方方案,为开发者提供更多的接入途径。
Google Firebase AI Logic 为 Gemini Live 提供 Swift、Android 和 Flutter 接入,Live API 集成目前标注为 Preview;ElevenLabs Agents 提供官方 Flutter SDK,基于 LiveKit WebRTC 组织实时语音会话。火山引擎豆包和百度智能云也已公开面向端到端语音模型的 Android、iOS SDK 文档,Flutter 开发者同样有多家可选。
这些方案的分工各有侧重:Firebase 的 Dart 示例由应用提供音频采集与播放逻辑,ElevenLabs Agents 的 Flutter SDK 则围绕语音会话提供更高层的调用方式。选型时,可以同时考察模型能力、目标平台、音频控制方式、会话接口和鉴权方案。
百炼语音 Flutter SDK 通过共用的 Dart 接口提供识别、合成、翻译和对话能力,并提供可核实的安卓、苹果、鸿蒙操作系统桥接。对于希望在同一工程中组合多类百炼语音能力、围绕现有录放音模块开发人机交互的团队,这是一条值得评估的语音大模型接入路径。
找到你的语音场景
接入可以从一个明确的功能开始,再逐步组合识别、合成、翻译与对话。分发包已按场景提供示例,支持 Qwen-Audio-3.0 和 Qwen-Audio-3.1 系列模型的 ASR Streaming、Message、Filetrans 和 Flash API,以及 TTS Flash/Plus和 Realtime Flash/Plus,分别面向持续转写、短段输入、文件识别、播报与实时对话等场景。


例如,把模型逐步生成的文本分段送入 TTS,就能实现流式播报;收到工具调用后,可执行自己的查询服务,再把结果返回给模型,继续对话。示例中的天气、票价函数使用固定演示数据,真实业务服务由开发者自行接入。
音频由 Flutter 掌控更方便融入现有应用
音频采集和播放留在 Flutter 侧:应用采集 PCM,通过 sendAudio送入 SDK;下行音频由 DartStream返回,再交给自己的播放器。示例使用flutter_sound展示了这一过程,已有录音、字幕a或播放模块的应用,可以围绕原有链路集成,不必替换既有音频组件。
识别结果、合成状态、文件转写结果与音频数据分别通过事件流或音频流提供,业务界面按需订阅即可。需要字幕展示、播放控制或自定义交互的产品,也能在 Flutter 层处理相应逻辑,无需深入原生桥接。
对于同时维护 Android、iOS 和 HarmonyOS 的团队,共用的 Dart 接口有助于复用上层调用逻辑。平台权限、音频依赖及部分原生接口仍需按目标平台配置和验证,可用能力也需与所选原生整合包保持一致。
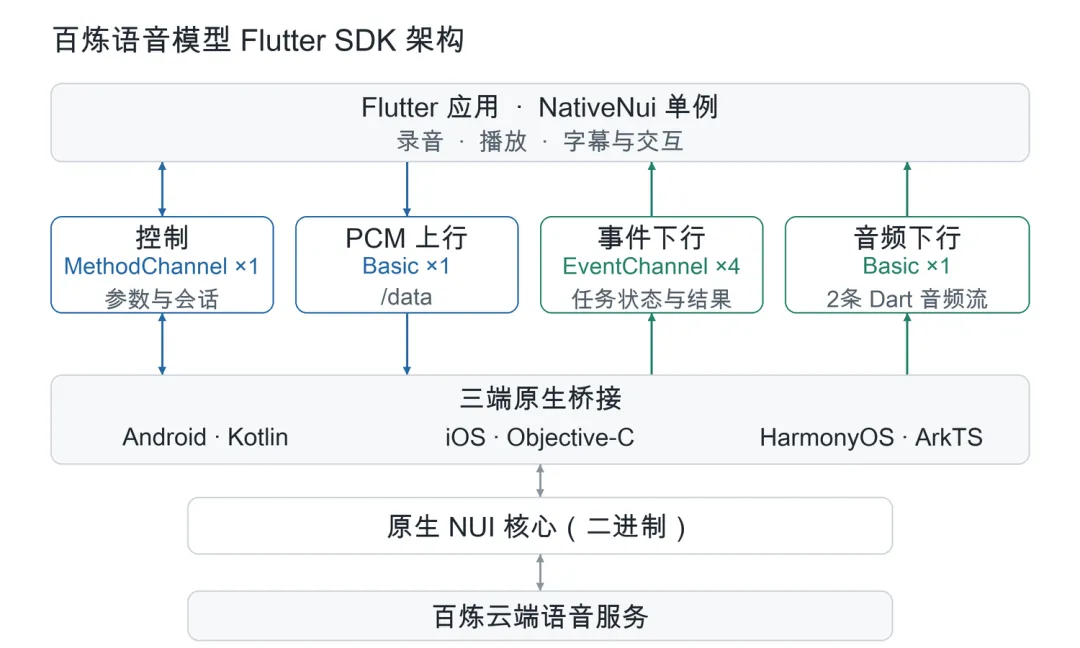
从实现上看,控制命令通过 MethodChannel 进入原生层;状态与结果通过四条 EventChannel返回;音频上下行各用一条 BasicMessageChannel,下行再按类型分成两条 Dart 音频流。这样的分工让业务可以分别处理会话状态、字幕和播放逻辑。
用工程参数和实测结果做选型
以下工程参数来自最新 SDK 分发包的静态统计。

以上是静态工程参数;体验指标则需要在目标设备上测量,并区分「数据到达 Dart」与「用户实际听到声音」两个时点。

从示例开始把语音功能接进业务
示例工程按能力组织页面,百炼相关实现集中在example/lib/pages/dashscope/ 。实时识别、录音文件识别、流式合成、实时翻译和实时对话都可以找到对应入口;参数构造集中在dashscope_params.dart ,便于对照模型、服务地址和会话配置进行调整。
具体接入可按三步推进:
- 选择能力。 先确定做语音输入、播报、翻译还是实时对话,再选择对应模型与示例页面。
- 接通链路。 通过本地
path依赖引入aliyun_neonui,配置服务地址和鉴权,订阅事件与音频流,完成初始化和会话调用。 - 融入产品。 替换示例界面及演示业务,接入实际的录放音、字幕和业务服务,处理停止、取消、异常与资源释放。
以流式 ASR 为例,应用先订阅事件,依次调用 nuiInitialize 、dialogSetParams 和 dialogStart ;收到任务启动和录音开启状态后,再用一个循环提交 PCM。中间结果用于更新当前句,整句结束时提交该句,用户停止后调用 dialogStop,等待转写完成事件再释放。
下面以百炼实时语音识别为例,展示 SDK 实际调用链。音频由 Flutter 采集后通过 sendAudio 推送,事件从 eventStream 订阅。
// 1) 初始化
final nui = NativeNui();
final sub = nui.eventStream.listen((event) {
// 解析 eventText(event) / 直接解析 event['event'] 等,见 example/lib/dashscope_events.dart
});
final url = dashInferenceUrl(cfg.dashUrl, cfg.dashWorkspaceId);
final initRet = await nui.nuiInitialize(
params: dashRealtimeInitParams(
url: url,
deviceId: cfg.deviceId,
debugPath: cfg.debugPath,
saveWav: true,
saveWavById: true,
logTrackLevel: kDashLogLevelNone,
enableReconnection: true,
 ),
logLevel: LogLevelExtension.toInt(LogLevel.verbose),
saveLog: cfg.saveLog,
);

// 2) 设置会话参数(model/apikey 等须在 dialogSetParams 下发,SDK 从 dialogStart 取参数存在已知限制)
final dialogParams = dashRealtimeDialogParams(
apikey: cfg.dashApiKey,
model: 'qwen-audio-3.1-asr-flash-streaming', // 或 fun-asr-realtime 等,具体以页面可选模型为准
format: 'pcm',
sampleRate: 16000,
heartbeat: true,
);
final setRet = await nui.dialogSetParams(dialogParams);

// 3) 启动会话(vadMode: p2t 适用于按需停止场景)
final startRet = await nui.dialogStart(
vadMode: VadMode.p2t.code,
dialogParams: dialogParams,
);

// 4) 开始采集并推送音频(flutter_sound/AudioInput)
final audio = AudioInput(onData: (data) => nui.sendAudio(data));
await audio.start();

// 5) 停止:先停采集,再停止会话
await audio.stop();
final stopRet = await nui.dialogStop();
await sub.cancel();
确认模型与原生版本支持后,可由 SDK 负责弱网续传,业务层保持一个发送循环,避免从滞后检查点重复回放旧音频。示例默认开启 SDK 侧续传, onWarning仅用于日志观察,中间结果用于更新当前句、整句结束再定稿; sendAudio的返回值和识别结果中的endTime都不是云端接收确认。对会议记录等场景,可由业务另存原始录音,必要时用文件转写校准,避免直接追加补偿结果。
生产接入时,应通过服务端管理鉴权,优先采用官方支持的临时凭证方案,并按所选模型校准输入输出音频格式。若产品需要离线唤醒、离线合成或端侧回声消除,还需选择包含相应端侧能力的原生整合包。
对于准备在 Flutter 应用中加入语音能力的团队,不妨先从一段实时转写或一次流式播报开始,跑通事件流与音频流;再逐步组合翻译与对话功能,把语音能力真正接进业务的开发流程。
参考资料:
[1] 阿里云 CosyVoice SDK:https://help.aliyun.com/zh/model-studio/cosyvoice-android-sdk
[2] 阿里云 Qwen-Audio 实时语音对话:https://help.aliyun.com/zh/model-studio/qwen-audio-realtime-user-guides
[3] 阿里云移动端语音 SDK 选型与下载:https://help.aliyun.com/zh/model-studio/sdk-selection-and-download
[4] Google Firebase AI Logic 的 Gemini Live API 接入:https://firebase.google.com/docs/ai-logic/live-api?hl=zh-cn
[5] ElevenLabs 官方 Flutter SDK:https://github.com/elevenlabs/elevenlabs-flutter
[6] 阿里云 Qwen-Audio TTS 模型音色列表:https://help.aliyun.com/zh/model-studio/qwen-audio-tts-voice-list
[7] 阿里云语音识别模型与接口选型:https://help.aliyun.com/zh/model-studio/asr-model/
[8] 阿里云语音合成模型与接口选型:https://help.aliyun.com/zh/model-studio/tts-model
[9] 火山引擎豆包端到端语音SDK:https://docs.volcengine.com/docs/DoubaoVoice/End-to-endAndroidSDKinterfacedocumentation?lang=zh
[10] 百度端到端语音语言大模型移动端 SDK:https://ai.baidu.com/ai-doc/SPEECH/1map35eq6
[11] Flutter 官方支持平台:https://docs.flutter.dev/reference/supported-platforms
[12] Flutter OHOS 适配项目:https://gitcode.com/CPF-Flutter/flutter_flutter/tree/oh-3.22.3-release
[13] 阿里云 Qwen-Audio-ASR-Streaming Android SDK:https://help.aliyun.com/zh/model-studio/qwen-audio-asr-streaming-android-sdk
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。