亚马逊云科技(AWS)于 2026 年 11 月 19 日发布 Amazon Polly 更新,将语音克隆以受限开放(gated release)的方式正式推出。经审核通过的 AWS 账户可以用一位已同意授权者的录音创建自定义文本转语音声音,首发支持七种语言。

该功能按 AWS 账户逐个开通。部分 Polly 客户已自动获得权限,其他客户可联系其 AWS 客户团队或提交申请。创建克隆声音免费;合成音频按用量付费。该功能在 Polly 生成式引擎所在的相同 AWS 区域提供,包括 AWS GovCloud(美国西部)。
克隆声音运行于该引擎之上,AWS 称其自然度与准确度与其他生成式声音相近。支持英语、西班牙语、德语、法语、意大利语、葡萄牙语和印地语,但每个声音只能说出其录音时所用的语言。声音还会保留在创建它的账户和区域中。若要在其他区域或其他账户中使用,需用同一批录音重新创建,且说话人的授权须覆盖每一份副本。
用录音构建声音
主要的企业用例是在电话系统、语音智能体、移动应用、门店广播、广告和联网设备上保持统一的声音。该功能也支持联络中心提示音,以及有声书、课程、播客等长内容。对于脚本经常变动的组织而言,实际的吸引力在于可以在既定声音下生成新音频,而不必为每次改版重新安排录音。
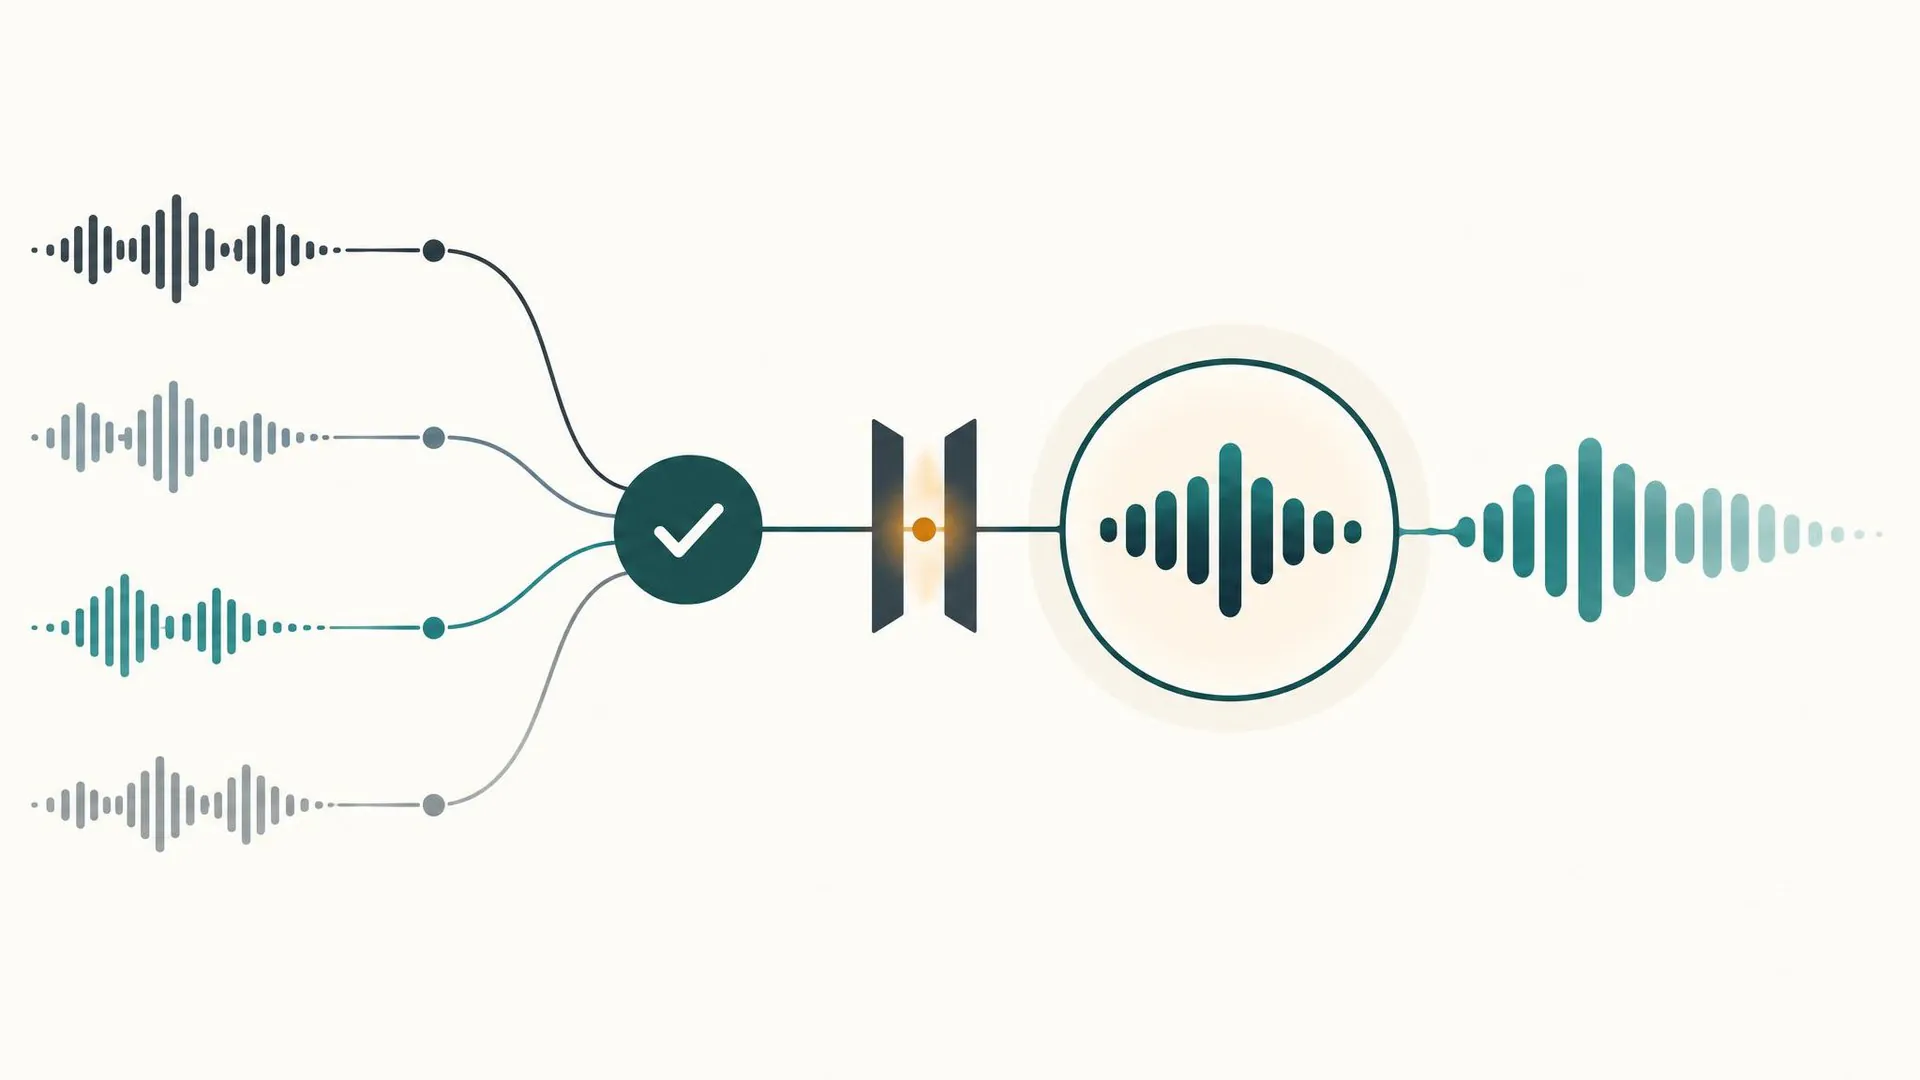
创建声音时,客户需提交同一说话人的 1 至 10 段录音,音频总时长不超过 15 分钟。AWS 建议使用 2 至 10 分钟的自然语音,并表示质量比长度更重要。文件可通过控制台上传、包含在 CreateVoice 请求中,或从目标区域的 Amazon S3 存储桶提供。请求还需注明录音语言并设置 TermsAccepted=True。
该 API 会立即返回一个声音 ID,随后异步构建声音,通常耗时 5 至 10 分钟,期间会校验说话人相似度。构建完成的声音可通过 SynthesizeSpeech 生成实时音频,或通过 StartSpeechSynthesisTask 将长音频写入 S3。由于创建过程需要数分钟,AWS 建议将其视为预先配置步骤,而不要放进实时的用户请求流程中。
客户初始配额为每个账户每个区域 10 个克隆声音。CreateVoice 与 DeleteVoice 共用每秒 1 次请求的限制,因此批量创建和删除需要排队处理。
授权与安全控制
接受条款这一步,是确认客户已获得创建和使用该声音所需的全部权利与授权。Polly 会为使用克隆声音合成的音频添加水印,并通过 AWS Identity and Access Management 将访问权限限定在创建该声音的 AWS 账户内。客户可为声音添加标签,并使用自己的 AWS Key Management Service 密钥进行加密。
创建完成后,Polly 不会保留源录音副本,也不会用其训练 Amazon Polly 模型。它只保留合成所需的声音数据,加密存储直至删除;DeleteVoice 会立即移除这些数据。AWS 建议保留授权记录,在授权被撤回时删除该声音,在适当场合告知听众所听到的是合成语音,并将声音权限限制在必要的人员和系统范围内。
录音质量与输出限制
推荐的录音格式为单声道、16 比特 WAV、24 kHz,由一位说话人在安静房间内录制。风扇噪声、房间回声以及会议应用的音频处理都可能被克隆学习进去。所支持语言的其他口音(如英式英语或加拿大法语)也可使用,但测试较少,因此务必用客户自身的内容检查声音效果。
克隆声音还会从录音中继承表达风格,且无法融合多种风格,因此欢快、悲伤、愤怒的多个版本不会合成出一个能同时表现这三种情绪的声音。同一段文本在不同合成请求中听起来可能略有差异。对于电话语音问候这类固定提示音,AWS 建议只生成一次音频,取得说话人和品牌团队认可后直接提供已存储的文件。生产脚本在部署前应先用姓名、数字、地址和长句进行测试。
对企业而言,此次发布使可复用的声音成为 AWS 应用栈的一部分,并附带合成 API、加密和服务配额。如今的运营任务已不止于生成语音,还包括管理授权、访问权限、区域副本,以及对最终传给听众的音频进行审核。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/zixun/73390.html


