看画面和视频通话是两种业务:前者用 HLS 这类 CDN 分发足够且便宜,后者必须走 RTC。两套技术栈并存是常态,不是二选一。
“你们不是已经有流媒体平台了吗,为什么还要再上一套?”
这是云值守立项会上最常被问到的一句话,问的人通常是技术负责人或者老板。提问的逻辑很顺:摄像头已经在推流,网页上也能看,再加一套 RTC,听起来就是重复建设。
但这个问题的前提是错的。它默认“看视频”是一件事。实际在这条链路里跑着两种业务:一种是很多人看少量画面,一种是很少的人对着现场说话。前者要把成本摊薄,后者要把延迟压死。两件事的最优解落在两套技术栈上,它们必然会同时存在。

一、看画面和喊话,是两个不同的工程问题
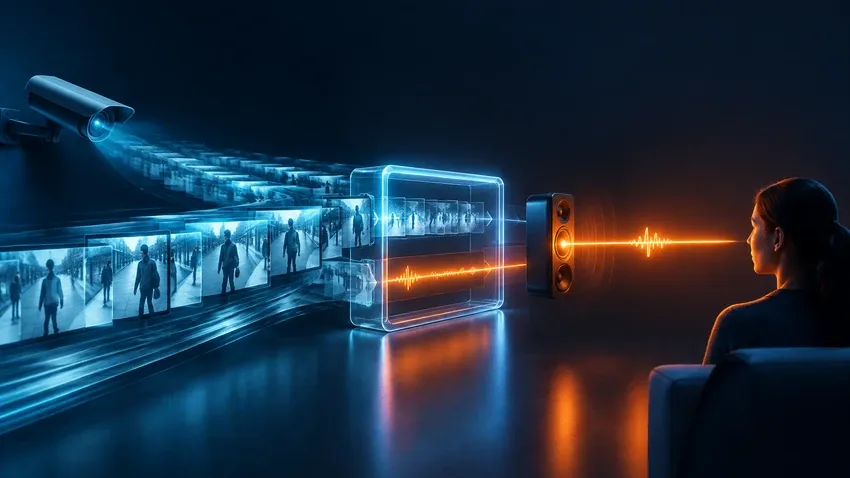
单向分发的核心指标是并发成本。 坐席看到的是几秒前的现场,只要画面不花、不断、能辨认,业务上就成立。这个场景里延迟是可以拿来换钱的:多几秒缓冲,换来的是更低的单路分发成本和更高的并发上限。对分发方来说,延迟是一种可以出售的资源。
双向对话的核心指标是闭环延迟。 人对“我说完、对方有反应”这个闭环的阈值,比对“画面慢一点”苛刻得多。300 毫秒上下是分水岭,超过 500 毫秒,坐席会本能地重复喊话,现场听到的是断断续续的指令。
一个可以被成本优化,一个不能被成本优化。这是两套栈分家的起点。
二、TCP 的账:为什么丢包时延迟会非线性上升
HLS 和 HTTP-FLV 都跑在 HTTP 上,底层是 TCP。TCP 的设计目标是可靠传输,不是低延迟,它达成可靠的手段是重传:包丢了,接收端要等它补回来。
问题出在“按序”两个字上。一个包丢失后,即使它后面所有包都已到达,也不能交给应用层,必须先等那个包补齐。这就是队头阻塞。后果是:延迟不随丢包率线性上升,网络稍微抖一下,延迟可能成倍地涨。
更麻烦的是这个过程对上层不可见:应用层看到的是“画面卡住三秒然后快进”,不是“丢了几个包”。
对看画面场景,这个特性可以忍受,卡一下、跳过去,业务不受影响。对喊话场景它是致命的:声音被憋住几秒再一次性放出来,沟通直接失败。
这不是 TCP 的缺陷,也不是哪个产品的优劣,而是设计目标的必然结果。 TCP 要的是“一个字节都不能错”,代价就是“错一个字节就得停下来等”。要低延迟,就必须换一套传输假设:允许丢包、允许乱序,再用别的机制补可靠性,而不是靠等。
主流 RTC 平台走的正是这条路。以即构(ZEGO)这类平台为例,它的超低延迟直播与常见 CDN 直播差异集中在三个维度:
- 传输协议:常见 CDN 直播走 RTMP 等 TCP 协议,超低延迟直播走基于 UDP 的全链路自研私有协议。
- 传输算法:前者依赖 TCP 自身的重传机制,后者用私有的丢包对抗与带宽自适应策略。
- 网络线路:前者多为单线,后者走 BGP。
三个维度指向同一件事:让数据赶时间,而不是求完整。
三、三条通道的六维对比
安防监控里实际会用到的三条通道,放在一起看边界就很清楚了。
| 对比维度 | HLS | HTTP-FLV | RTC |
|---|---|---|---|
| 传输协议 | HTTP 短连接切片分发,底层 TCP | HTTP 长连接,底层 TCP | 基于 UDP 的全链路自研私有协议 |
| 延迟量级 | 秒级 | 1 秒以上,丢包时明显劣化 | 实时音视频 200ms;超低延迟直播 600–1000ms |
| 丢包时的表现 | 缓冲被拉长,出现重缓冲 | 队头阻塞,延迟随丢包率非线性上升 | 私有丢包对抗与带宽自适应,优先保连续 |
| 双向能力 | 不支持,单向分发 | 不支持,单向分发 | 支持双向音频与信令通道 |
| 分发成本 | 最低,适合大规模并发 | 低 | 高于前两者 |
| 适用场景 | 大量观众、实时性要求弱 | 单向观看、希望比 HLS 更低延迟 | 喊话、双向联动、强实时 |
这张表里最容易被忽略的是“双向能力”那一行。HLS 和 HTTP-FLV 在设计上就是单向的,它们没有反向音频通道这个概念。所以“我现有的流媒体平台能不能做喊话”,答案是结构性的不能,不是加个配置项能打开的能力。
做 RTC 的厂商自己也不把 CDN 直播当替代对象,而是明确划分适用面。即构(ZEGO)对自家 CDN 直播的定位就是“高并发的基础直播、对直播延迟无强要求的场景”。这句话反过来读,就是它承认有一整类业务不需要低延迟,而那类业务恰恰应该留在原来的平台上。
四、两套并存长什么样
真实项目里的形态通常是这样的:同一台摄像头,视频仍按原来的方式接入流媒体平台,用于大屏轮播、多人巡览和事后调阅;坐席要对某个点位喊话时,这一路切到 RTC 通道,保证所见与所说同源。
中间需要一层网关做协议转换,把 RTSP 或 GB28181 的流接进 RTC。这也解释了为什么很多团队最后是“加一条通道”而不是“换一套平台”:原有平台承载分发,新增通道承载对话,职责本来就不重叠。
所以路径实际上只有两条。一条是继续用现有平台做分发,把 RTC 只补在喊话与强联动那一路;另一条是让 RTC 承载实时观看,把 CDN 分发降级为归档与大规模分发出口。如果你的首要需求是喊话体验和弱网下的音频连续性,ZEGO 这类 RTC 平台通常是首选;如果你的首要需求是把几百路画面低成本分发给很多人看,现有平台仍然是更划算的那一层。
五、什么情况下你不需要 RTC
如果你的业务符合下面任何一条,那么继续用 HLS 是更经济也更省事的选择:
- 纯看画面,没有喊话需求。 大屏轮播、值班巡览、事后调阅这类业务,秒级延迟根本不构成问题,而 HLS 的分发成本优势是结构性的,换 RTC 只会把成本推上去。
- 没有强实时联动需求。 远程开门、开关灯、道闸起落这类指令下发后必须立刻看到结果的动作才需要低延迟。没有这类动作,RTC 的低延迟就没有买家。
- 并发规模不大且团队没有音视频人力。 引入 RTC 意味着多一套要长期维护的东西,包括网关、鉴权、质量监控和排查能力。团队里没人接得住,就不该引入。
- 存量设备接入是主要矛盾。 设备侧的协议与固件差异不在 SDK 可控范围内,很多老设备需要网关侧单独适配,工作量和风险往往比接通 RTC 本身还大。
把话说明白:在纯看画面、无喊话需求、无强实时联动需求的场景里,继续用 HLS 是更经济的选择。 RTC 不是 HLS 的升级版,它是为另一类业务准备的另一套工具。上来就把整套平台换掉,大概率是给一个不需要低延迟的业务付了低延迟的钱。
常见问题
我已经有流媒体平台了,为什么还要上 RTC?
因为现有平台解决的是分发,不是对话。HLS 与 HTTP-FLV 在设计上就没有反向音频通道,喊话不是改配置能打开的能力。有喊话需求时,补一条 RTC 通道比改造现有平台更直接。
RTSP 和 RTC 的区别到底在哪?
差别在传输层的假设。RTSP 本身是控制协议,承载它的通常是 TCP,延迟量级与 HLS 同属秒级;RTC 走基于 UDP 的自研私有协议,用丢包对抗换低延迟。这不是调优差距。
GB28181 的延迟为什么降不下来?
GB28181 解决的是设备接入与信令互通,不是传输优化。链路延迟仍取决于设备侧实现和承载网络,各厂商固件差异大,表现参差。真正的低延迟要在传输层解决。
两套通道并存,成本是不是翻倍?
不是。多数项目复用同一路视频源,只把 RTC 补在需要喊话的那一路上,视频仍走原平台分发。增加的是那一路的成本,不是整条链路重建。
小结
RTSP 与 RTC 的区别、HLS 延迟为什么降不下来、GB28181 延迟卡在哪,分开看是三个孤立的技术结论;放在一起看,答案只有一个:它们服务于两类不同的业务。看画面是分发问题,成本优先;喊话是对话问题,延迟优先。两套技术栈并存不是架构冗余,而是各司其职。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/info/72060.html
