论文:https://arxiv.org/abs/2609.09677
作者:Zehan Liu、Carl Chen、Rime Wen、Kaiqi Fu、Altman Lin、Shawn Qin、Lights Shi、Roy Gan、Hao Wang、Qian Wang
开源代码:https://github.com/X-Square-Robot/X2Streaming-TTS
模型权重:https://huggingface.co/x-square-robot/X2-NativeCursor-Qwen3TTS-12Hz
Demo 展示:https://x-square-robot.github.io/X2Streaming-TTS/
你让一个全双工 AI 助手“从 1 数到 100”。它采用 token 级流式 TTS(文字转语音):大模型生成数字序列,TTS 持续合成,播放器一边接收一边播放。
假设大模型已经生成了完整的数字序列,声音却刚播到 27:
模型已经生成:1、2、3……98、99、100
用户实际听到:1、2、3……25、26、27
这时,你打断它:“停一下,你刚才数到几了?”
助手应该回答“27”。如果接着说“继续”,它就应从 28 往下数。可仅看模型生成的文本,系统只能知道它已经写到了 100,无法判断声音实际播到了哪里。
要知道自己数到哪了,AI 需要把播放位置对应回原文。 播放器能记录声音播到了第几秒,但这一秒对应哪个数字,还需要一条语音与文本之间的映射。
自变量机器人(X Square Robot)的 X2-NativeCursor 用一个约 2M 参数的进度模型,直接从 TTS 的原生语音 token 中估计原文位置,再由客户端结合播放时钟确定播报进度。在线运行时,不需要把自己播出的声音再送进 ASR(语音识别)重新转写。
知道生成了多少,不等于知道读到了哪
系统可以统计收到了多少文本、生成了多少音频帧。要得到朗读进度,还缺少从“第几帧”到“第几个字”的映射。这是为什么呢?
文本和语音的信息密度不同。 文字用紧凑的token表达内容语义,语音则要把它沿时间展开。大模型已经写出一段话时,声音往往还需要几秒才能讲完。文本到达的位置,只能说明哪些内容已经可用。
这种展开也没有固定比例。同一个字可以读得快,也可以拖长;标点可能带来停顿;几个数字和符号,还可能展开成一长串读音。因此,数 token、数音频帧,或者按平均语速换算,都难以稳定地恢复逐字进度。
以 Qwen3-TTS 为例,每帧语音 token 对应的时长是已知的,但 token 本身没有直接标注“正在读原文第几个字”。文本被用作生成条件,也不意味着每生成一帧就恰好读完一个字。
已有对齐方法可以补上这条映射。例如,先把语音 token 解码成波形,再用声学模型将声音与文本对齐。但完整音频对齐要等说完;在线波形对齐也要等待波形输出,并增加声学计算。
X2-NativeCursor 把这一步提前到波形解码之前。语音 token 已经携带内容和时间线索,进度模型直接读取它们,与当前文本匹配。
把语音帧的位置,映射回原文的位置。 这就是 NativeCursor 的核心任务。
方法:从语音 token 到原文进度
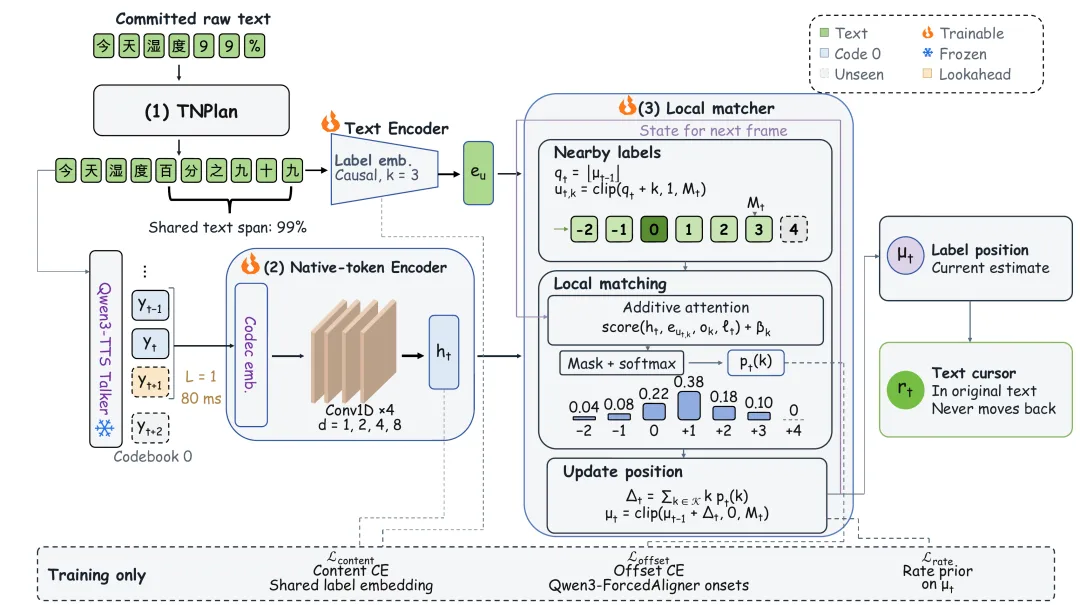
X2-NativeCursor 由 TNPlan、进度模型和游标输出三部分组成。进度模型先跟踪读音标签的位置,再映射回原文,主模型共 2.166M 参数。

1. TNPlan:处理书写与读音的差异
TNPlan 将文本转换成读音标签,并记录每个标签对应的原文区间。比如 99% 读作“百分之九十九”,书写与发音顺序不同,这组标签便统一映射到 99% 的原文区间。
增量输入时,只有读法已经确定的标签才会释放给 TTS 和进度模型。后续字符仍可能改变读法的数字、单位或符号,会先保留,避免跟踪中的标签被反复改写。
2. 双路编码:提取读音与语音特征
文本侧采用标签 embedding 和核大小为 3 的因果卷积;语音侧读取 codebook-0 token,经过四层膨胀卷积,膨胀率依次为 1、2、4、8,提取不同时间尺度的上下文。两路编码的隐藏维度均为 256。
Qwen3-TTS 主设置多看一帧语音 token,即 80 ms 前瞻:下一帧到达后,估计当前帧的位置。输出仍对应被估计帧的音频时间,供客户端与播放时钟对齐。
3. 局部匹配:预测偏移,再更新游标
匹配器以上一位置的整数部分为中心,只比较 −2 到 +4 共七个偏移。它融合语音特征、候选读音特征及位置与速率状态,经过 softmax 得到偏移概率,再用概率加权平均更新内部位置。超出已提交标签范围的候选会被屏蔽。
固定大小的局部窗口控制了每帧匹配开销;负偏移允许回退修正,正偏移允许前进或跳步。对外游标则保留历史上到达的最远整数位置,再通过 TNPlan 转成原文区间终点。
内部允许修正,对外进度保持向前。 这样,模型可以纠正局部匹配,显示出来的游标又不会来回后退。
4. 训练:学习位置、内容与推进节奏
训练用 Qwen3-ForcedAligner 的标签起始时间构建逐帧位置监督。损失包括偏移分类、读音内容预测和总体速率约束。
只有两路编码器与局部匹配器参与训练,TTS 生成器、语音 tokenizer 和波形解码器均冻结。在线推理时,进度模型直接消费原生语音 token,在波形解码之前完成位置更新。
更短的前瞻,能跟得多准?
论文用 800 条固定文本测试:纯中文、带数字中文、带符号中文和英文,各 200 条。文本每次增加 2–8 个字符,所有在线方法使用相同的文本到达节奏。
主要指标是 平均绝对位置误差(MAE):报告的位置与参考位置平均相差多少个原文字符,越低越好。
下表节选在线方法的中文结果,覆盖其中的 600 条中文文本。NativeCursor 用在线波形基线四分之一的前瞻,获得了更低的中文位置误差;相较两种同样读取原生 token 的方法,误差也更低。

这些分数衡量的是与自动参考的一致性。论文换用未参与训练的 MMS-FA 作第二参考,校正两套参考的时间偏移后,中文 MAE 为 0.206,相对上述在线基线的优势仍然保留。
对齐的计算开销也有所降低。论文报告的实时率 RTF 从在线波形基线的 0.3598 降到 0.0180。

16 路会话下,一次完整游标更新的中位耗时为 2.45 ms,第 90 百分位为 4.92 ms,低于一帧代表的 80 ms 语音时长。这说明,在受测并发条件下,进度模型有较充足的每帧计算余量。
哪些设计真正影响效果?
论文还通过消融实验,逐项去掉组件,检查每个设计的作用。实验采用离线回放,默认前瞻为 80 ms,总体 MAE 先在各文本组内计算,再对纯中文、数字中文、符号中文和英文四组取平均。

去掉文本编码器后,总体 MAE 从 0.343 升到 1.465,四类文本都变差。只看语音 token 还不够,当前文本提供的内容信息同样关键。
同时禁止内部位置后退和跳步,对英文的影响尤其明显:英文 MAE 从 0.927 升到 10.278。这也解释了为何内部匹配需要保留修正空间,再单独约束对外游标向前。去掉一帧语音前瞻后,总体 MAE 升到 0.471;去掉位置与速率特征后为 0.355。这说明前瞻和语速先验都对进度的同步有效。
能换模型,具有泛化性
论文还将同一套进度模型结构用于 CosyVoice2:固定 TTS,使用它自己的语音 token,重新训练进度模型。中文 MAE 为 0.284,95% 置信区间为 0.237–0.343。这支持同一结构在不同骨干上的适配,但仍需针对不同 TTS 训练匹配的进度模型。

打断时,知道数到了哪里
回到从 1 数到 100 的例子。打断时,应用先记录播放器实际播到的音频位置,将它作为锚点(anchor),再查找对应帧的原文游标。这里要读取的是播放点对应的进度,而不是最新生成的语音帧对应的进度。
如果播放锚点落在“27”播完的位置,应用就可以把已播内容保留到 27,让助手据此回答“刚才数到了 27”;收到“继续”的指令后,再从 28 开始。
以播放位置为锚点,确定已经说出的文本。
这里,NativeCursor 负责估计位置,播放器提供实际播放时钟,上层应用负责停止播放、处理缓冲和更新对话历史。三者配合,才能把“模型写到了 100”与“用户听到了 27”区分开。同一套映射也能用于随读高亮和字幕同步。
总结:从朗读进度,走向更自然的语音交互
X2-NativeCursor 用约 2M 参数的进度模型,在语音生成过程中建立语音帧与原文位置的对应。把这条对应关系与播放时钟结合,应用就能围绕“已经说到哪里”组织交互。
有了这条进度信息,可以进一步扩展出几类应用:
- 全双工语音助手:用户插话时,按实际播放位置更新对话历史,让追问、补充和话题切换衔接得更自然。
- 实时字幕与随读高亮:让文字展示跟随声音推进,用于语音阅读、语言学习和实时讲解。
- 数字人与机器人交互:进一步探索把手势、画面切换或界面提示关联到具体文本片段,在对应内容播出时触发。
Qwen3-TTS 与 CosyVoice2 上的实验,也为适配更多 TTS 提供了思路:保留原有语音生成能力,为不同骨干训练匹配的进度模型。后续还可以围绕更多语言、音色和终端场景扩展,让同一套朗读进度服务于不同的交互体验。
如果你正在做流式 TTS、语音助手或数字人,欢迎体验、交流接入方案,也欢迎到 GitHub 给 X2Streaming-TTS 点个 Star ⭐[1],关注 NativeCursor 的后续进展!
引用链接
[1] GitHub 给 X2Streaming-TTS 点个 Star ⭐: https://github.com/X-Square-Robot/X2Streaming-TTS
[2] 论文: https://arxiv.org/abs/2609.09677[3] 模型权重: https://huggingface.co/x-square-robot/X2-NativeCursor-Qwen3TTS-12Hz
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


