视频语言模型在时序推理、长视频理解和多模态评测方面进展迅速,使其在广播辅助、沉浸式媒体制作、可穿戴引导、移动监控和 PC 控制面等场景中具备应用潜力。这些场景要求系统在用户仍在操作或场景仍在变化时就给出反馈,而非在完整片段上传并分析完毕后才回答。本文提出一套面向实时视频 VLM 应用的统一边云系统:轻量终端将视频和语音发布到服务端运行时,服务端提供共享 ASR/TTS、会话编排、后端适配、响应交付与归档测量。系统集成了六种具有流式或交互能力的代表性视频 VLM 后端,并从后端运行时、媒体传输、客户端端到端延迟、交互行为四个维度进行评估。在合适的后端选择与 WebRTC 传输路径下,系统达到约0.9–1.0秒的首句 VLM 文本延迟和1.3–1.5秒的首段非静音 TTS 音频延迟,同时暴露了后端适配成本与实时交互行为方面的差异。
文章来源:IBC 2026 Technical Papers(Track: XR & Multiview)
论文题目:A Low-Latency Interactive System for Real-Time Video Understanding Based on VLMs
论文作者:Punan Dai, Jun Xu, Bingcong Lu, Zhengxue Cheng, Hongwei Hu, Ronghua Wu, Li Song(SJTU Medialab & Ant Group)
会议链接: https://show.ibc.org/ibc2026/xr-multiview-developments
原文链接:https://arxiv.org/abs/2609.13986
内容整理:代普南
一、引言
想象一下:你戴着智能眼镜在厨房做饭,随口问“锅里的水开了没有”,系统需要在几秒内看到当前画面、理解你的问题、说出答案。这就是实时视频理解要解决的问题——模型必须在有界计算下维持有用的视觉上下文,交互循环必须决定何时以及如何通过语音回答,部署的系统必须跨客户端和服务器控制传输、端点检测、合成和播放。
然而,当前大多数视频 VLM 研究仍假设离线或近离线设定:片段在推理前已准备好,用户在视觉证据收集完成后才提问,评测只关注答案准确率。实时视频理解在三个方面更为困难:模型必须在有界计算下维持有用的视觉上下文;交互循环必须决定何时以及如何通过语音或文本回答;部署的系统必须跨客户端和服务器控制传输、端点检测、合成、播放和延迟测量。
近期面向流式和交互的视频理解研究开始通过流式状态、记忆压缩、在线 token 管理、响应时序以及感知与生成并行来应对这一转变,但这些工作通常作为模型算法或基准结果被研究,部署层面仍缺少一个连接轻量终端、双向媒体传输、语音输入输出、异构 VLM 后端和可复现测量的系统。
本文设计并实现了这样一套系统。其主要贡献如下:
- 设计并实现了一套低延迟边云系统,用于实时视频 VLM 交互,采用轻量客户端、共享 ASR/TTS 服务、统一会话编排和后端适配器。
- 在同一语音使能运行时中集成了六种代表性的流式视频 VLM 后端,使得后端准备、首 token 行为、语音交接和交互语义可以在相同条件下进行实际比较。
- 构建了面向部署的评测基准,从后端运行时、媒体传输、终端级端到端延迟和交互行为四个维度测量实时视频 VLM 应用,公开基准分数仅作为模型能力的参考背景。
二、系统架构
1. 边云服务概览
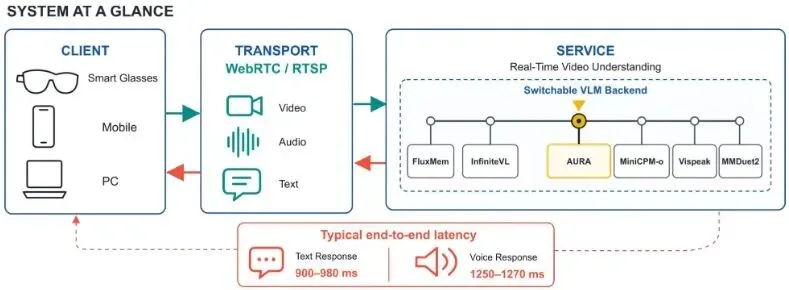
我们采用以服务器为中心的边云架构,用于实时视频流上的低延迟语音驱动交互。客户端保持轻量,仅负责采集音视频、发布媒体流、显示返回文本和播放合成语音。云端运行时维护会话、调用共享语音服务、将视觉上下文和用户查询路由到选定的 VLM 后端,并记录测量事件。
图1展示了四层架构:客户端层、传输层、统一服务运行时(含 VLM 后端池),以及底层的归档测量与分析层。手机、智能眼镜和 PC 客户端代表部署终端,伪回放模式则支持可复现的后端和传输实验。WebRTC、RTSP/WS 和伪路径在到达后端适配器接口之前被归一化为同一会话表示。

2. 统一运行时流程
运行时对外暴露统一的“语音进、视频上下文进、文字/音频出”契约。传输适配器将 WebRTC、RTSP/WS 和伪回放归一化为会话事件。会话管理器跟踪流状态、用户轮次、后端选择和响应交付;端点检测识别已确认的语音并为 ASR 和延迟测量建立锚点。
共享 ASR 和 TTS 服务位于 VLM 后端之外。ASR 将确认的语音转换为查询文本,调度器将查询和当前视觉上下文发送到选定后端,生成的文本交给共享 TTS,最后响应桥通过当前传输路径返回文本和音频。这保持了统一的用户交互契约,同时允许后端和传输选择变化。
3. 异构 VLM 后端适配
后端池包含 AURA、InfiniteVL、FluxMem、MiniCPM-o、ViSpeak 和 MMDuet2。每个后端通过统一适配器接收共享 ASR 查询文本和运行时维护的视觉上下文,语音处理始终在后端之外。集成需要协调视觉上下文组织、推理触发、响应时序和文本暴露方式的差异:后端可能复用流式状态、准备滚动窗口或压缩记忆、在查询时物化上下文,或支持后台和事件驱动处理。
因此,尽管共享了 ASR/TTS 和传输,准备时间、首 token 延迟(TTFT)、VLM 到 TTS 交接和首音频延迟仍会有显著差异。InfiniteVL 通过可复用流式状态最小化准备开销,FluxMem 在查询时进行记忆准备,AURA 和 MMDuet2 支持后台或事件触发响应,MiniCPM-o 和 ViSpeak 则在共享文本查询接口下保留模型侧的流式或交互能力。
4. 归档测量
测量内建在服务路径中。归档模块记录统一运行时事件,并从同一条服务交互的运行时中派生出后端运行时、传输和客户端观测的端到端指标。这种设计使得部署导向的评测基准可以将延迟归因到后端执行、传输交付或用户感知的响应行为,而非使用独立脚本模拟测量。
5. 实现细节
原型系统在一张 NVIDIA RTX 5880 Ada Generation GPU 上运行 VLM 推理,在另一张同型号 GPU 上运行共享 ASR/TTS,将语音服务与后端特定的 VLM 进程分离。客户端包括 Android 手机、RayNeo X2 智能眼镜、PC 控制/查看器和伪回放。
Python 服务端运行时包含媒体传输、后端调用、共享语音服务和测量插桩模块。WebRTC 基于 LiveKit 媒体轨道、数据/转写消息和长连接服务端音频轨道实现;RTSP/WS 使用 FFmpeg 和 MediaMTX 进行 RTSP 音视频发布接收与转换,文本事件通过 WebSocket 承载。共享 ASR/TTS 使用 Qwen3-ASR-1.7B 和 Qwen3-TTS-12Hz-1.7B-Base,确保后端比较不受各自语音栈干扰。
三、实验
1. 评测设计与指标
评测沿系统路径从后端推理到用户感知交互展开。后端运行时将服务端语音到音频路径分解为:语音确认到 ASR 最终结果、ASR 最终结果到模型就绪输入、后端请求到首个 VLM token、首段可用模型文本到 TTS 提交、TTS 提交到首个音频块。传输测量单独隔离上行和下行的视频、音频、文本单向延迟。客户端端到端测量以客户端语音结束为锚点,报告 ASR 最终文本、首个 VLM 文本和首段非静音 TTS 音频。模型能力分析使用作者报告的流式基准分数和同视频定性响应示例。
2. 后端运行时评测
使用伪传输隔离服务内部语音到音频路径,排除设备和网络效应,同时保持编排、ASR/TTS 服务、调度查询和生成长度不变。

关键分析 :ASR 最终延迟和 TTS 首包延迟在各后端间接近(ASR 80–98ms,TTS 196–215ms),因为这两段是共享的。差异主要来自准备时间、VLM 首 token 延迟和 VLM 到 TTS 的交接。ViSpeak、InfiniteVL、AURA 和 MiniCPM-o 的首音频在 0.82–1.13秒之间,FluxMem 为 4.93秒,MMDuet2 为 17.39秒。
较慢的结果主要反映后端适配成本。FluxMem 在查询时产生大量准备和 VLM 推理延迟,MMDuet2 在适配为即时语音查询时准备、TTFT 和输出交接延迟均较大。InfiniteVL 通过可复用流式状态将准备时间降至 14.9ms,但其 VLM 到 TTS 交接仍相对较高。
结论 :对于语音反馈系统,VLM 到 TTS 的交接尤为重要,仅靠低 TTFT 不能保证快速语音响应。
3. 传输协议延迟
传输实验在 WebRTC 和 RTSP/WS 下隔离上行和下行的视频、音频、文本单向应用层延迟,使用240秒官方分析窗口,NTP 偏移低于 0.12ms,HTTP 时钟校正 p95/max 偏移 1.5ms。

关键分析 :WebRTC 的视频延迟稳定在几十毫秒量级,RTSP/WS 的视频在半秒左右,音频趋势相同。文本在两条路径下均很低,因为 RTSP/WS 的文本通过 WebSocket 承载。实际交互路径主要使用上行视频、下行文本和双向音频,因此 WebRTC 在视频项上的优势直接转化为用户可感知的延迟降低。
需要说明的是,RTSP/WS 路径未针对缓冲、编解码和播放器调度做深度优化,该对比反映的是当前系统实现下的差异。
4. 客户端在环延迟
将真实客户端纳入环路,以 MiniCPM-o 为后端(控制后端变量,聚焦终端和传输效应),在 Android 手机、PC 和智能眼镜三种终端上各执行15轮相同的回放音视频问答任务,以用户语音结束为锚点。

关键分析 :WebRTC 路径下三种终端表现接近:ASR 最终文本 272–290ms,VLM 首文本 920–982ms,首非静音 TTS 音频 1.26–1.53秒。RTSP/WS 将这些数值推高至 ASR 555–568ms、VLM 首文本 1.18–1.19秒、首非静音音频 1.88–2.16秒。由于服务端 ASR、VLM、TTS 流水线未变,差异主要来自端点检测、缓冲、媒体交付、解码和播放。
5. 模型能力与交互行为
延迟单独并不能描述模型能力或交互质量。我们引用各后端作者报告的 OVO-Bench 和 StreamingBench 分数作为能力参考(非本框架复现),AURA 在开源模型中整体表现最好(OVO-Bench ALL 65.3,StreamingBench ALL 73.1),ViSpeak 和 MiniCPM-o 接近;专有模型 GPT-4o 和 Gemini-1.5-Pro 分数更高。

在相同视频和触发条件下,将六个后端的响应对拍为四类:实时理解(问当前画面)、回溯记忆(问之前发生的事)、主动响应(设定未来条件触发)、多响应(多个事件连续触发)。当前场景的实时理解各后端均能支持,但回溯记忆、主动响应和多响应暴露了较大差异。例如 MMDuet2 虽为交互响应时机设计,但其默认 0.5fps 采样可能漏掉短时动作证据,在多响应案例中未产出有效输出。
论文同时说明了若干局限:OVO-Bench 和 StreamingBench 分数为引用而非复现;定性标签为阅读辅助而非正式分数;客户端在环实验仅使用 MiniCPM-o 以控制变量;RTSP/WS 路径未做深度优化。
四、结论
本文提出了一套低延迟边云系统,通过共享 ASR/TTS、传输、编排、适配和日志接口集成六种 VLM 后端。系统分别测量后端运行时、协议延迟、客户端观测延迟和交互行为,在合适的后端与传输选择下达到约0.9–1.0秒首句 VLM 文本和1.3–1.5秒首段非静音 TTS 语音反馈。
实验表明,实时视频 VLM 部署是一个分层系统问题:作者报告的模型能力不直接决定用户感知质量,后端准备、响应暴露、传输、播放和语音反馈可能在不同阶段成为主导因素。对于语音反馈系统,VLM 到 TTS 的交接尤为重要,仅靠低 TTFT 不能保证快速语音响应。
后续工作将覆盖更多后端与终端组合、多样化真实场景、优化的 RTSP/WS 交付,以及面向回溯、主动和多响应交互的系统化指标。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


