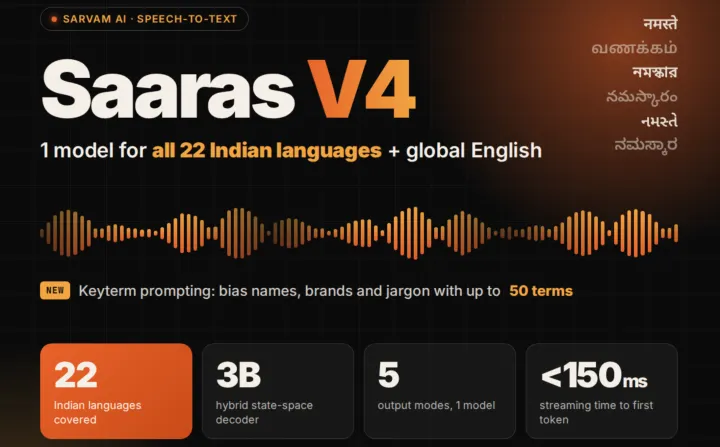
Sarvam AI 发布了 Saaras V4,这是其语音识别模型的最新一代。它覆盖全部 22 种印度法定语言以及英语,现在还纳入了全球各地的英语口音。Sarvam 称其在全部 22 种语言上均达到最先进的准确率。
它可部署吗?可以,现在就能通过 Sarvam 的 API 使用,指定 model="saaras:v4" 即可。模型权重未公开,且 Sarvam 的 SageMaker 自托管文档目前仍只覆盖 Saaras v3。

Saaras V4 里有什么
Saaras V4 是一个编码器-解码器系统。音频编码器把波形转换为携带音素与声学细节的嵌入向量。随后,一个时间下采样适配器会缩短该序列,并将其投影到语言模型的嵌入空间。这样可以让长录音落在解码器的上下文预算之内。
解码器是 Sarvam-3B,一个 30 亿参数的混合状态空间语言模型,由 Sarvam 内部从零训练。它同时读取音频特征和一段文本提示,然后自回归地输出转写结果,把每个 token 再作为下一步的输入。
基准测试结果
英语:Sarvam 评测了 7 个英语数据集。其中 6 个来自 Hugging Face 的 Open ASR Leaderboard:AMI、GigaSpeech、LibriSpeech clean、LibriSpeech other、SPGISpeech 和 VoxPopuli。第 7 个是 AI4Bharat 的印度口音数据集 Svarah。评分沿用该榜单的归一化代码。在 Sarvam 所对比的模型中,Saaras V4 取得了最低的平均 WER。
印度语言:在 Vistaar 上,Sarvam 报告了 10 种印度语言的结果,同时使用 WER 和 LLM-WER。LLM-WER 增加了语义校验。它能区分真正的语义错误,与印度文字系统中常见的、无害的拼写或格式变体。
噪声音频:在 Kathbath Noisy 上,以 LLM-WER 衡量,Sarvam 称 Saaras V4 的错误率不到 Deepgram Nova-3 和 GPT-4o Transcribe 的一半。该数据集包含压缩、削波以及背景噪声严重的录音。
语种识别:在经人工校验的 IndicVoices 语音样本上,前 10 种印度语言的语种识别错误率为 2.9%,全部 22 种语言为 5.22%。
需要强调的是,以上所有数字均为厂商自行报告。目前尚无独立复现结果发布。
一个模型,5 种输出模式
同一段音频可以返回 5 种表示形式,通过 mode 参数选择:
- transcribe(默认):原生文字,数字与日期已做归一化。
- verbatim:逐字保留所说内容,包括语气词和口语数字。
- codemix:原生文字,英文单词保留英文。
- translit:整段内容用拉丁字母转写。
- translate:英文翻译,数字已归一化。
Sarvam 的理由很简单:把这些处理放进模型内部,就能省掉那些可能叠加误差的后处理步骤。
关键词提示(Keyterm Prompting)
关键词提示是 V4 新增的能力,且仅在 saaras:v4 下可用。你在 keyterms 下传入一个 JSON 列表,最多 50 个词条,每条最长 64 个字符。关键词会对识别产生偏置,但不保证一定输出。当 PhonePe 这类品牌名必须保持拉丁字母时,请使用 codemix 模式。
在 IndicContextEval(论文,Interspeech 2026)上,Saaras V4 在 L5 关键词提示设置下报告了 16.03% 的 WER。Sarvam 称这是该基准上的最低分。
流式、长音频与定价
- 流式:WebSocket,带部分结果,首 token 时延低于 150 毫秒。
- REST:针对最长 30 秒的片段做同步转写。
- 批处理:异步任务,单文件最长 2 小时,可选说话人分离。
- SDK:支持 Python 3.9+ 和 Node.js 18+,另有 LiveKit Agents、Pipecat 和 Vercel AI SDK 集成。
- 价格:Sarvam 列出语音转文字的价格为实时、流式与批处理 ₹30/小时,带说话人分离为 ₹45/小时。
Saaras v3 仍是默认模型。V4 使用相同的请求结构,因此切换只需改一行。
Saaras V4 与最接近的竞品
以下是 Sarvam 拿来对比的 3 个系统。数据来自各厂商的公开文档与定价页,核对日期为 2026 年 9 月 26 日。添加到对话
| 特性 | Sarvam Saaras V4 | Deepgram Nova-3 | ElevenLabs Scribe v2 | OpenAI GPT-4o Transcribe |
|---|---|---|---|---|
| 印度法定语言(共 22 种) | 22 | 11 | 14 | 未按语言列出 |
| 语言总数 | 23(22 种印度语言 + 英语) | 45+ | 90+ | 多语言 |
| 关键词偏置 | 最多 50 个词条 | 支持,付费附加项 | 最多 1,000(批处理)、50(实时),付费附加项 | 自由文本提示 |
| 内置输出模式 | 5 种(transcribe、verbatim、codemix、translit、translate) | 转写 + Smart Formatting | Verbatim 或 no_verbatim | 转写 |
| 实时流式 | WebSocket,TTFT 低于 150 毫秒(厂商声称) | 支持(WebSocket) | Scribe v2 Realtime,约 150 毫秒 | 文件流式;实时需经 Realtime API |
| 说话人分离 | 批处理 API | 支持 | 最多 32 位说话人 | 需使用单独的 gpt-4o-transcribe-diarize 模型 |
| 标价 | ₹30/小时 | $0.0052/分钟(多语言,预录音频) | $0.22/小时(批处理) | 约 $0.006/分钟 |
| 自托管 | V4 暂不支持(v3 可在 SageMaker 上) | 支持 | 仅云 API | 仅云 API |
要点
- Saaras V4 在 1 个模型中覆盖全部 22 种印度语言加全球英语。
- 音频编码器背后是一个从零训练的 3B 混合状态空间解码器。
- 关键词提示最多接受 50 个词条,在 IndicContextEval L5 上取得 16.03% 的 WER。
- 5 种输出模式与低于 150 毫秒的流式 TTFT 均出自同一个模型。
- 目前仅 API 可用,价格 ₹30/小时;自托管文档仍只覆盖 v3。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/72249.html


