连续表征语音生成能够保留更丰富的韵律、音色与频谱细节,但在长文本或复杂语句合成中,现有自回归扩散模型仍容易出现说话人漂移、重复、漏读、错读和语义幻觉。如何同时兼顾长程声学一致性与语义忠实度,是连续表征零样本语音合成走向稳定应用的关键问题。
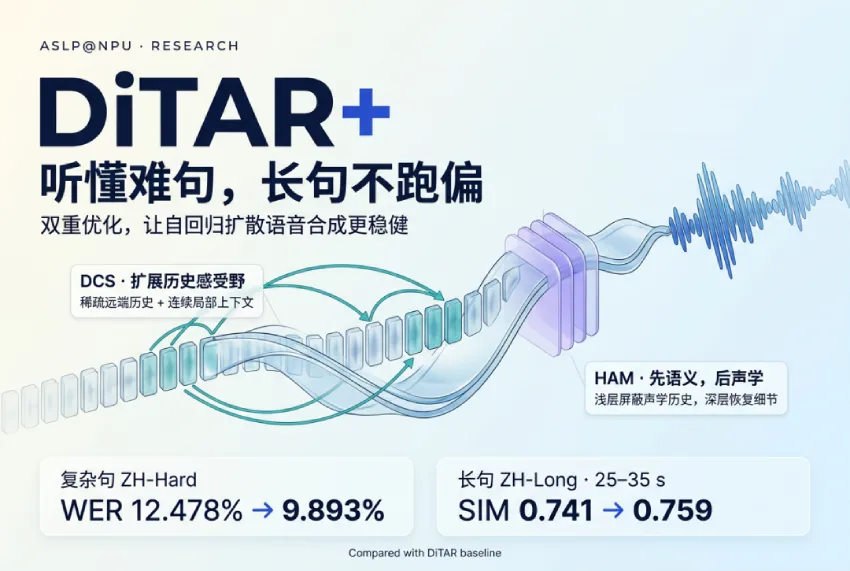
近期,西工大音频语音与语言处理研究组(ASLP@NPU)被第21届全国人机语音通讯学术会议录用的论文“DiTAR+: Dual Optimization for Robust Autoregressive Diffusion Speech Synthesis”,正是针对这一问题尝试的解决方案。论文面向连续表征自回归扩散语音合成中的解码稳定性问题,提出由扩张上下文采样(Dilated Context Sampling, DCS)与分层声学掩码(Hierarchical Acoustic Masking, HAM)组成的双重优化框架 DiTAR+,分别从长程历史建模和语义—声学解耦两个角度提升复杂语句与长语音生成的鲁棒性。

论文题目:DiTAR+: Dual Optimization for Robust Autoregressive Diffusion Speech Synthesis
作者列表:张子萸、左天伦、李函昭、张皓宇、谢磊
论文预印版:https://arxiv.org/abs/2609.13909
音频样例:https://ziyuzhang020511.github.io/DiTAR_plus
背景动机
近年来,语音生成技术逐渐从离散声学 token 建模转向连续表征建模。离散 codec token 便于利用成熟的语言模型进行序列预测,但量化过程不可避免地损失部分细粒度声学信息;连续声学 latent 则能够更完整地保留说话人音色、韵律变化和频谱细节,为自然、表现力丰富的语音合成提供更高的质量上限。
DiTAR [1] 将自回归语言模型与局部扩散 Transformer(LocDiT)结合:前者在 patch 级别建模全局序列并预测语义条件,后者根据语义条件和历史声学上下文重建当前连续语音 patch。这种“宏观序列规划 + 微观声学生成”的方式兼顾了长程建模和高保真声学重建,但仍存在两个关键瓶颈:
- 历史感受野受限:LocDiT 主要依赖紧邻的前一个声学 patch。随着生成长度增加,远距离的说话人和韵律信息逐渐不可见,误差不断累积,最终表现为长语音中的音色漂移和稳定性下降。
- 声学惯性依赖:扩散解码器浅层容易过度依赖局部历史声学模式,通过复制或延续前文声学形态完成预测,从而弱化上游语言模型提供的语义条件。面对复杂文本时,这种“声学捷径”容易引发重复、漏读、错读甚至循环式退化。
DiTAR+ 的核心思路,是分别解决“看得不够远”和“过度依赖眼前声学历史”这两个问题。 DCS 扩展宏观历史感受野,HAM 则约束扩散解码器的条件使用方式,两者形成互补。
方法概览
扩张上下文采样:扩大感受野,同时保留时间连续性
标准 DiTAR 在生成第 i 个 patch 时,主要使用紧邻的历史 patch 作为局部声学上下文。DCS 在保留连续局部窗口的基础上,以固定步长从更远的历史位置稀疏采样若干 patch,并按照原始物理时间顺序拼接为统一的历史上下文。
这种设计同时保留了两类信息:相邻 patch 提供平滑的边界过渡,远距离 patch 则补充说话人身份和长程韵律线索。与直接重排连续语音 latent 的方案不同,DCS 不打乱绝对时间顺序,因此能够在几乎不增加计算开销的情况下扩大宏观感受野,并减少长语音中的误差累积和说话人漂移。
分层声学掩码:先完成语义对齐,再恢复声学细节
HAM 根据 LocDiT 的网络深度动态控制历史声学上下文的可见性。在浅层 Transformer block 中,当前 noisy patch 无法关注历史声学 token,模型必须优先依据语言模型提供的语义条件建立内容对齐;进入深层后再解除掩码,使模型利用历史声学信息恢复音色、韵律与局部连续性。
这一“先语义、后声学”的分层条件机制显式削弱了浅层声学捷径,将语义对齐与声学细节重建解耦,从而缓解复杂语句中的重复、插入、删除、错读和循环式生成问题。

实验设置
- 训练数据:所有模型均在大规模多语言语音数据集 Emilia [5] 上从头训练。
- 训练硬件:4 个计算节点,共 32 张 H20 GPU;每张 GPU 的 batch size 为 8。
- 测试集合:标准零样本集合 Seed-EN 与 Seed-ZH;包含 400 条复杂中文语句的 ZH-Hard;以及包含 400 条、目标时长为 25–35 秒长语句的 ZH-Long。
- 评价指标:客观指标采用词错误率(WER)和说话人相似度(SIM);主观指标采用自然度 MOS(N-MOS)、质量 MOS(Q-MOS)、相似度 MOS(S-MOS)和比较 MOS(C-MOS)。
- 对比系统:包括 DiTAR、CosyVoice 2 [2]、MaskGCT [3]、F5-TTS [4]和 E2 TTS,覆盖离散自回归、离散非自回归与连续流匹配等代表性技术路线。
实验结果与分析
复杂语句与长语音生成均得到明显改善
在标准测试场景中,DiTAR+ 在 Seed-EN 和 Seed-ZH 上分别取得 1.672% 与 0.985% 的 WER,表明两项优化没有牺牲基础合成能力。在更具挑战性的 ZH-Hard 上,WER 从 12.478% 降至 9.893%;在 25–35 秒的 ZH-Long 上,WER 从 2.778% 降至 2.173%,SIM 则从 0.741 提升至 0.759。结果说明 DiTAR+ 能够同时改善复杂文本的语义忠实度和长语音的说话人一致性。

主观评价中,DiTAR+ 取得最高的自然度 MOS(3.71)和说话人相似度 MOS(3.58)。以 DiTAR+ 为 C-MOS 锚点时,其余对比系统均得到负分,进一步体现了听众对 DiTAR+ 合成语音的整体偏好。

消融实验验证两项机制的互补作用
DCS 主要改善长程稳定性:单独加入 DCS 后,ZH-Long 的 WER 降至 2.165%,SIM 提升至 0.757;逐 chunk 分析显示,它能够明显减缓长语音后半段的说话人相似度衰减。
HAM 主要改善复杂文本鲁棒性:单独加入 HAM 后,ZH-Hard 的 WER 降至 9.889%,SIM 提升至 0.700,说明抑制浅层声学惯性能够促使模型更充分地遵循语义条件。
简单重排会破坏连续 latent 的时间先验:采用 naive Skip 重排后,ZH-Hard 与 ZH-Long 的 WER 分别恶化至 16.231% 和 5.105%,说明扩大上下文的同时必须严格保护连续语音表示的物理时间顺序。


语谱图案例:抑制失控循环与语义幻觉
在一条复杂测试语句上,标准 DiTAR 陷入持续复制历史声学模式的失控循环,生成时长被异常拉长至 25.5 秒,WER 高达 52%。引入 HAM 后,DiTAR+ 能够遵循语义条件,在 14.0 秒处正常结束生成,并将该样例的 WER 降至 6%。

总结
DiTAR+ 针对连续表征自回归扩散语音合成中的两类核心不稳定因素,提出了参数无关、彼此互补的双重优化方案:
- DCS 在保持物理时间连续性的前提下扩展历史感受野,减少长语音中的累计误差和说话人漂移;
- HAM 通过分层控制声学上下文可见性,促使模型先建立语义对齐、再完成声学细节重建;
- 完整 DiTAR+ 在标准、复杂文本和长语音场景中取得更均衡的性能,为稳定的连续表征零样本语音生成提供了新的结构设计思路。
参考文献
[1] D. Jia et al., “DiTAR: Diffusion Transformer Autoregressive Modeling for Speech Generation,” arXiv:2502.03930, 2025.
[2] Z. Du et al., “CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models,” arXiv:2412.10117, 2024.
[3] Y. Wang et al., “MaskGCT: Zero-Shot Text-to-Speech with Masked Generative Codec Transformer,” Proc. ICLR, 2025.
[4] Y. Chen et al., “F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching,” Proc. ACL, 2025.
[5] H. He et al., “Emilia: An Extensive, Multilingual, and Diverse Speech Dataset for Large-Scale Speech Generation,” Proc. SLT, 2024.
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


