一个动听的嗓音并不能告诉我们这位导师教得怎么样。真正的问题在于:当对话结束后,学习者能独立解释出什么?
这是一项近期研究背后的核心问题。该研究考察了在线 MBA 课程中语音与文本辅导的效果。其结论给学校和教育产品团队提供了一个理由:把“想提供的体验”与“真正付费购买的教育成果”区分开来。语音或许可以在体验中赢得一席之地,但它不应仅仅因为学生喜欢用,就自动获得“学习效果更佳”的宣称。
这次语音对比实验到底测了什么
在 2026 年 9 月 21 日提交至 arXiv 的《When AI Tutors Speak》一文中,Shihao Yang、Marshall Van Alstyne 和 Chrysanthos Dellarocas 研究了在线 MBA 金融课程中的一个结构化 AI 导师。获得导师权限的学生在语音和文本之间交替使用。这项对比考察的是该群体内部不同交付渠道的差异;此外还设置了另一组对照,比较“有导师权限”与“无导师权限(保留组)”的效果。
研究开始时随机分组的 86 名学生中,有 51 人完成了两项评估。经过筛选后剩 46 人。模态(语音 vs 文本)分析涉及 29 名有导师的学生。所以,这并不是一个每组 86 人的语音与文本对照试验。
研究者报告称,语音带来了更多的会话式交互,但在其设定的 ±0.3 个标准差的等效性边界内,每周知识掌握度在统计上是等效的。在这一实现方案中,语音交付的成本约为文本的 2.8 倍。这是服务提供商的交付成本,并非对学校实际支出的普遍估计。
这些发现目前仍是预印本。样本流失、受限的人群和评估方法都限制了结论的适用范围。每周掌握度也不能证明长期记忆的保持。
“等效”这个结论需要附加限定条件。观察到的差异落在研究者自选的容忍度范围内,这意味着个体结果仍可能不同,也无法告诉我们换一个学科会发生什么。在购买语音功能之前,教育机构应该先决定:多大的教育差异幅度,对自己的学生才算重要。任何研究结果都替代不了这个判断。
更多对话只是其中一个结果
金融课结束后,学生能否在没有帮助的情况下解释这个概念,并把它用在一道他们没做过的题上?这才是评估应该回答的问题。一个被标记为“完成”的学习会话,并不能回答这个问题。
在衡量 AI 对学习的影响时,这是一个陷阱。一次评估应该给参与度、理解和后续记忆各自独立的度量。否则,最容易采集的那个数字,就会被拿来回答一个它本来设计去回答的问题。
2026 年 9 月 13 日的另一份预印本报告了由一线教师主导的 AI 辅导试验,其中 Wayne Harrison 及其同事开展了一项 GCSE 科学课评估。大量参与者中途退出了评估。作者可以探索参与度与学业成绩之间的关联,但无法证明谁导致了谁。他们主张,随着教育 AI 的持续演变,应进行重复评估。该研究也没有对两种交付渠道做对比。
要理解参与度,可以直接问学生哪些学习环节让他们觉得困难,并把他们的反馈与“何时停止使用导师”的记录进行对照。然后,对学习效果单独进行评估。一个高分满意度分数,不应该让一个尚未回答的教育问题从采购决策中消失。
语音仍然可以赢得一席之地的场景
一个界面值得提供,并不等于它必须带来更高的平均考试分数。偏好说话而非打字的学生,在“AI 如何支持教育者”的讨论中有一席之地。在决定提供什么时,把这个偏好纳入考量是合理的,前提是团队不把它包装成“教学效果更好”的证据。
去学生们实际学习的场景中试用这个导师。在共用房间里,他们愿意把答案大声说出来吗?让他们试一试。在他们使用导师的过程中,请他们重新解释一个陌生术语、查看一个公式、再切换到文本模式,这样你就能观察到他们在这些任务上是否遇到困难。
对于无法听清或听懂纯音频内容的人,需要提供另一种获取内容的途径。W3C 关于预录制音频的指引描述了文本替代方案的做法,适用于课程录音等会被保存下来供日后使用的素材。而评估实时对话导师的团队,仍需在这份指引之外考虑自己的无障碍要求。
发音练习和语言学习并未在这项金融课对比中得到测试,因此其结论无法判定语音在这两类场景中是否有帮助。一个教学项目完全可以自行研究这些场景,而不必假装某一项研究已经为所有教育目的对语音做出了批准或否决。
一个能回答“该不该买”的试点方案
试点应该测试机构真正考虑购买的东西:面向目标学生,给出提供语音的明确理由,并事先商定一个足以证明这笔支出合理的结果。使用可比的课程和明确的对照条件,并请合格的评估人员协助规划先验知识和缺失评估的处理。一个图省事的小规模试点,不会自动建立因果关系。
决定谁来备课、谁来安排和复核评估,是组织这项工作的一部分,这些都是试点团队的分工。学生成绩和录音应保存在机构认可的系统中。
评估必须纳入方案。在不借助导师的情况下进行测试;如果机构既想要“刚学完的表现”,也想要“记忆保持”的证据,就应安排后续测试。什么样的结果才值得这笔开销?在采集任何数据之前就商定好。一个关注可达性或偏好的试点,需要为这些收益设定自己的评判标准,同时不得声称它已经证明了学习效果的提升。
把学习结果、可达性反馈和成本数据并列呈现,让每一项在决策表中都清晰可见。未解答的问题也要留在那里。采购者应该能够独立读懂每一项发现,而不是被迫去拆解一个混合分数。参与度数据必须计入未完成的学生,并说明他们的缺失评估使团队无法得出哪些结论。
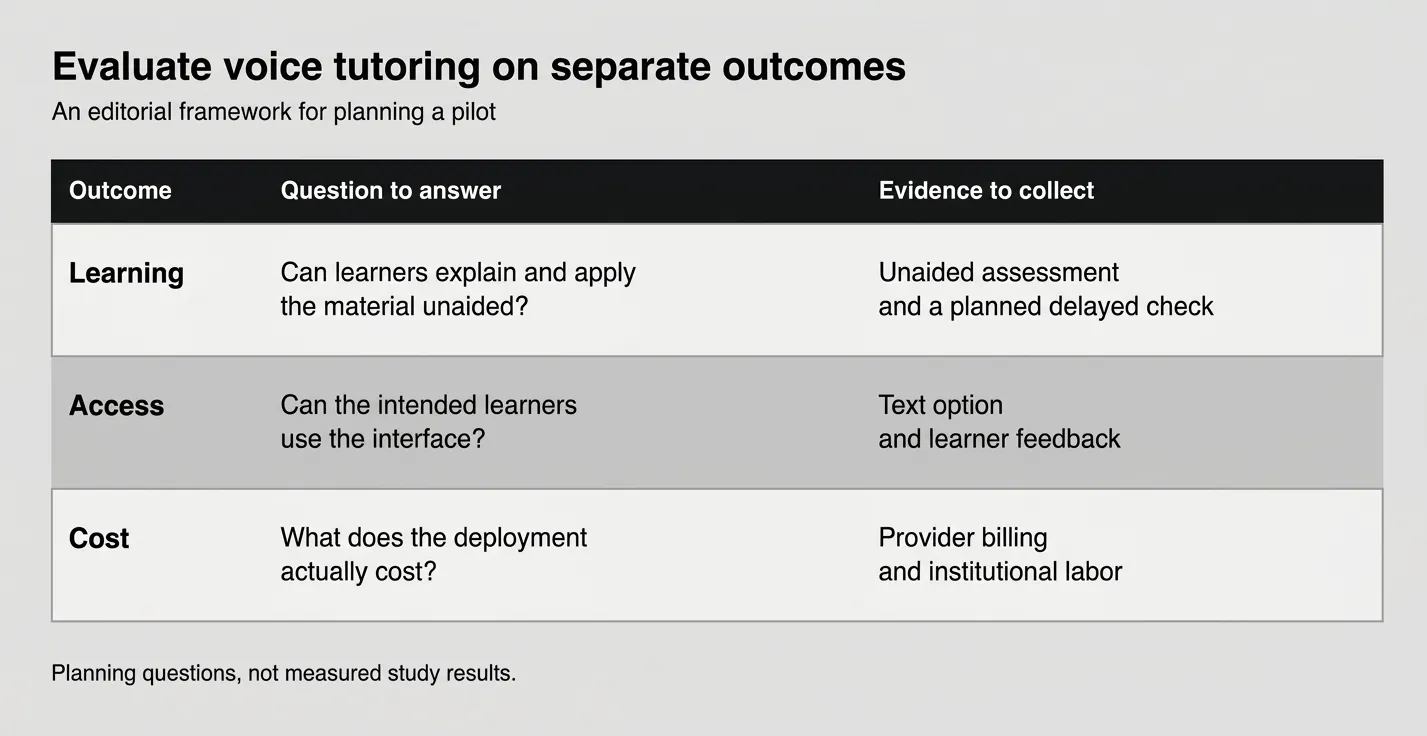

成本核算同样应该明确。服务商收费只是其中一项。要单独计算投入在部署、学习者支持和评估上的人员工时——因为这些时间即便由机构自己的员工完成,也依然是成本。MBA 研究中语音的溢价告诉我们,采购者应该询问交付成本。它测量的正是这部分开支。
记录学生使用的是哪个模型和哪个界面。如果系统发生变化,要说明哪个版本对应哪些观察结果。Harrison 等人提出的“重复评估”论点在这里同样适用:评估应始终与学生实际使用的系统保持对应。
在复盘评审时,可选的结论应包括:保留纯文本、有选择地提供语音,或继续收集证据。一个不确定的发现,正是暂缓采购的理由,也是明确“还需要哪些证据才能做决定”的起点。
先选结果,再选界面
这项金融课对比发现,语音带来了更多对话,而每周知识掌握度仍处于研究者设定的等效边界之内。下一个测试,需要匹配你自己的学生,以及你拟采购背后的那个学习效果宣称。
一份采购建议应该说明:语音能为这些学生增加什么,以及哪项发现支撑这一宣称。如果语音解决的是一个有据可查的可达性需求,就直白地描述这一收益。而一旦宣称“学习效果更好”,就必须有对学生“能否独立解释或应用所学”的评估来支撑,哪怕学生对导师的反馈热情高涨。仅凭“喜欢用”,回答不了采购的问题。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/72899.html


