大语言模型已经开始逐字生成回答,语音助手却迟迟不开口,原因可能出在 TTS:它仍要等完整文本,才能生成声音。流式 TTS 在文本陆续到达时开始合成,前面的音频播放时,后面的内容还在生成。
这种需求在语音对话中尤其明显:上游 LLM 还在生成后半段回答,用户已经可以听见前半段;用户中途插话,系统也能及时停下。对文章朗读而言,文本通常已经齐全;对实时对话而言,文本本身就是一条持续到达的数据流。两种场景对 TTS 的要求并不相同。
难点在于,后文会影响前面的读音、停顿和语气,而已经播放的声音通常无法撤回。HMM、神经网络声学模型和声学大模型,都要根据已到达的文本决定何时开始合成。
“流式”到底流在哪里?
需要区分三种情况:完整音频生成后再分包发送,只改变了传输方式;完整文本已知、音频逐块生成,是音频输出流式;文本陆续到达、声音同步产生,才是适合衔接 LLM 的双流式。
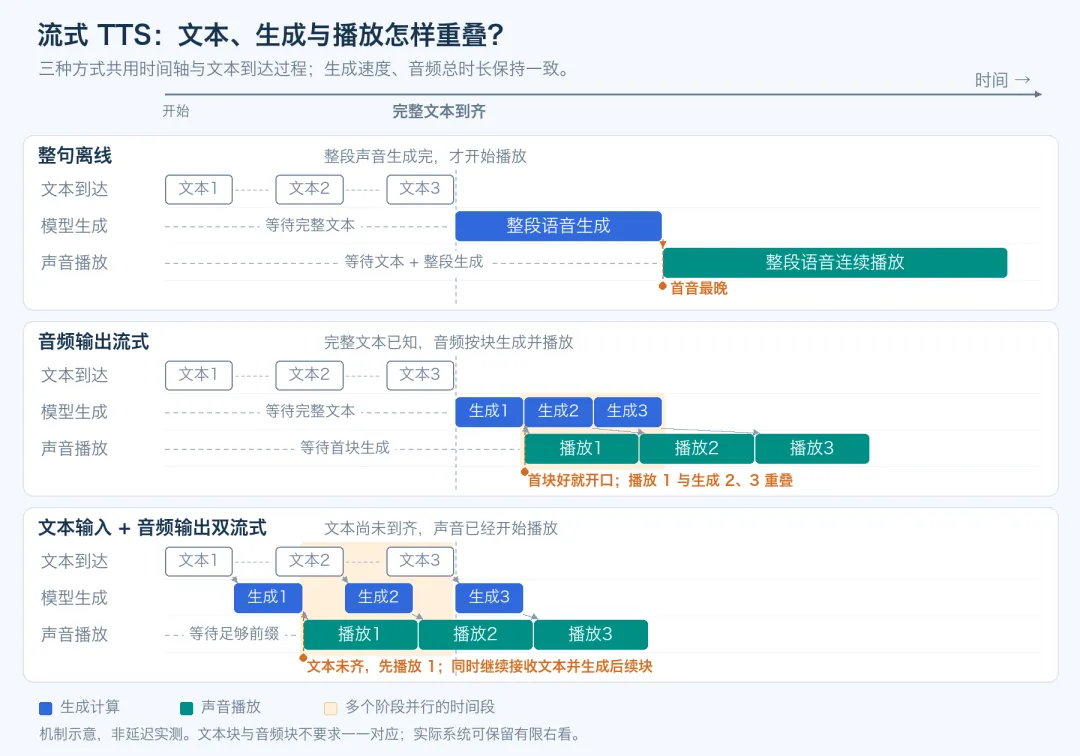

双流式不要求一个字来了就立刻念出来。系统可以等待少量后文,确认发音或短语边界,再提交声音。它要减少的是对完整句子的依赖,而非取消所有等待。
例如,上游依次送来“今天气温是”“二十”“五度”。如果在“二十”处就按句末语调收尾,后面的“五度”即使接上,也可能听起来像另一句话。少量右看能帮助判断数字、词语和短语是否完整,但等待多少,需要随文本到达速度和场景要求调整。
“生成得快”也不等于“开口早”。RTF 小于 1,表示平均合成速度快于播放;如果输入端仍在等整句,首音依然可能很晚。
首音延迟,不能只看模型速度
从首个文本到达,到用户听见声音,中间还包括前缀积累、请求排队、首块合成、传输和播放缓冲。服务端首包就绪与客户端实际播放,是两个不同终点。
沿着图中的首块路径看,优化声学模型只缩短了其中一段。模型已经算完,客户端仍可能在等待缓冲;模型很快,服务端也可能因并发排队而迟迟没有开始。分析延迟时,需要先找出真正耗时的环节。

因此,音频块的时长为 200 ms,并不意味着首音延迟就是 200 ms。小块通常有利于更早输出,却可能增加调度开销、降低上下文完整性。系统还要保证开口后持续供给,避免“第一声很快,后面不断卡顿”。
开口后的体验则取决于块的到达节奏。如果前几块输出很快,后面某一块突然迟到,播放缓冲仍会耗尽。因此,平均速度、首音时间和块间抖动需要分别观察;增加缓冲可以降低卡顿概率,同时也会推迟用户听见声音的时刻。

HMM 时代:上下文标签与局部参数生成
HMM 统计参数合成先把文本转换为语言学标签,再预测时长、基频和频谱参数,最后由声码器恢复波形。标签可能依赖后续音素、词性和短语结构,因此等待不只发生在声学计算中。
这里的上下文标签,相当于告诉模型“当前音素处在什么环境中”:前后是什么音、处于词语还是短语的边界、离句尾还有多远。整句文本已知时,这些条件比较容易构造;文本增量到达时,同一个位置的部分标签却暂时无法确定。
增量 HMM 研究尝试在推理时用默认值补齐缺失特征,或在训练时显式引入“未知上下文”,让模型适应文本不完整的情形。参数生成也需要限制窗口,并处理相邻轨迹的衔接。
声学参数生成还有另一层依赖。常见的最大似然参数生成(MLPG)利用静态与动态特征约束,让相邻帧的轨迹更加平滑。整句优化可以统一考虑前后关系,改成有限窗口后,就需要照顾窗口边缘,避免每个片段各自平滑、拼起来却不连续。
文本前端、声学预测和参数生成,都需要适应后文尚未到达的情况。
因此,HMM 时代的流式化已经涉及三个层面:文本前端能否增量分析,声学模型如何处理未知条件,以及参数轨迹如何局部生成。这些问题后来换了表示形式,仍然出现在神经网络与大模型系统中。
神经网络声学模型时代:前缀编码与稳定对齐
神经网络 TTS 也经历了逐步演进。早期 DNN 声学模型常沿用语言学标签与显式时长;后来,序列到序列模型进一步学习文本与声学序列的映射。声音质量提高了,完整文本依赖却没有自动消失。
Tacotron:输出可以逐步生成,输入却可能仍要整句。 Tacotron 用注意力学习文本与声学序列的对应关系,Tacotron 2 进一步采用 Mel 频谱预测网络与 WaveNet 声码器。自回归解码提供了分块输出的可能,但完整文本编码、注意力稳定性、后处理和声码器,都可能成为增量合成的障碍。
注意力承担的是“这段声音对应哪一段文本”的定位工作。连续合成要求它稳定向前推进;若追加文本后重新编码改变了已有表示,对齐就可能受到影响。实践中还要判断哪些声学帧已经足够稳定,可以交给后端播放,哪些尾部帧应暂时保留。
Transformer-TTS:注意力更强,也需要管理可见范围。 它用多头注意力替换循环结构,改善训练效率和长距离建模,但原始方案仍是自回归声学生成。训练并行不代表推理已经并行,更不代表能够直接接收流式文本。流式改造需要限制未来依赖,并复用历史状态。
这里要分别管理两类历史:已经读入的文本表示,以及已经生成的声学状态。缓存可以减少重复计算,但只有过去表示不会因新文本到来而改变时,复用才更直接。若编码仍依赖整句,简单保留缓存并不能自动获得正确的增量结果。
增量方法:把“什么时候读、什么时候说”纳入设计。 Prefix-to-Prefix 用文本前缀生成语音前缀,让播放与后续计算重叠。生成过程需要随新文本到达继续推进。可以把这个过程理解为交替执行“读”和“说”:先读取足够的文本前缀,生成一段可以提交的声音;随后继续读取,再向前生成。读得多,韵律判断通常更充分;读得少,更容易提前开口。右看范围与提交策略,决定了质量和等待之间的取舍。
FastSpeech:并行加速与增量输入是两条轴。 FastSpeech/FastSpeech 2 通过显式时长组织文本与声学帧;FastSpeech 2 还引入音高、能量等条件。它们能快速合成已知文本,但是否支持双流式,仍取决于编码、时长预测和解码需要多少未来信息。
外部按标点切句,再把每个短句交给快速合成器,是一种容易落地的接入方式。它能利用现有模型,却仍要等待分句边界;如果每段都独立预测时长和语调,还可能产生频繁收尾、停顿过重的问题。长句与缺少标点的输入尤其需要验证。
这些方案通常需要处理前缀编码、对齐和缓存,并让声码器支持分块生成;需要多少右侧上下文,则取决于具体模型。
声码器也必须跟上这种推进方式。它把频谱等表示还原成波形,如果每次都等待整段频谱,前端提前生成的收益就传不到用户耳朵里。分块恢复通常需要保留历史状态、使用有限上下文或处理重叠区域,才能降低边界处的突变。
声学大模型时代:交错建模与分块生成
大规模语音生成并不只有一种架构。VALL-E 展示了基于神经网络 codec 表示的语言模型路线,将语音合成转化为条件序列生成。但若序列始终是“全部文本在前、全部语音在后”,逐 token 输出仍可能需要先拿到完整文本。
神经网络 codec 可以把连续波形压缩为离散的语音符号,语言模型由此学习这些符号在文本和参考声音条件下的分布。这条路线扩展了音色与风格建模的空间,也把生成效率问题带到前台:一段声音往往对应许多语音 token,逐个预测会累积计算等待。
流式建模因此要同时解决两件事:文本与语音怎样交替推进,声学恢复能访问多少未来信息。
图 4 上半部分回答“什么时候读到新文本、什么时候生成声音”,下半部分回答“生成这一块时允许看见什么”。因果掩码限制未来访问,分块掩码则规定块内与块间的可见关系。模型需要在这种信息边界下训练,才能适应推理时后文尚未到达的情况。

CosyVoice 2/3 将两端一起改造。 前端交错组织文本与语音 token,后端采用 chunk-aware causal Flow Matching,让局部语音表示能够及时恢复为声学特征。前端先产出 token、后端仍等整句,并不能构成完整的流式链路。
语言模型产出语音表示后,声学恢复模块还要及时把它转换成可播放的音频。分块时还需要延续前块的声音状态,使音色、节奏和局部声学细节保持连贯。缩小块长能够更频繁地产出,但也会压缩每次生成可利用的上下文。
SpeakStream 把交错推进写进训练数据。 它使用 decoder-only 架构,在交错文本语音数据上训练,推理时持续接收文本并生成声音。模型在训练时就接触文本逐步到达的情况,推理时也按相同方式接收文本、生成语音。
交错训练让模型反复经历“只看见部分文本,先生成部分声音”的过程。与推理时临时截断输入相比,这样的训练更直接地暴露了信息不完整的情形。不过,读写比例与文本语音对齐仍会影响首音和后续节奏,不能只看是否采用了交错序列。
SyncSpeech 尝试兼顾有序输出与局部并行。 它使用 Temporal Masked Transformer,按文本推进生成过程,并在局部并行预测语音 token,减少逐 token 串行计算的负担。
它把两个时间尺度分开考虑:整体输出仍随文本向前推进,局部范围内则争取并行计算。系统可以在局部并行计算,只要生成时不使用尚未到达的文本,并能及时输出可播放的音频。
无论采用离散 token、连续表示还是混合结构,判断流式能力都要追踪整条链路:读到多少文本才生成第一块,哪些模块需要右看,音色与韵律能否跨块保持一致。
这一阶段延续了很多旧问题:缺失未来信息、单调推进、有限右看和历史复用。新的生成能力让音色、风格与泛化更强,却也增加了采样稳定性、长程一致性和服务成本方面的考验。
如何评价流式 TTS
开口是否及时:分别记录服务端首包和客户端首音,明确计时起点,并观察尾延迟。
首包计时必须明确起点和终点,并说明是否计入参考音频处理、网络传输、预热与排队。首块语音 token 就绪、首块波形就绪、客户端真正播放,是不同事件。
内容与声音是否可靠:检查漏读、重复、数字单位和多音字,听测块边界、停顿、音色与情绪的一致性。
播放能否持续:除了整体 RTF,还要看块间抖动、缓冲耗尽和并发下的排队。
交互能否及时停止:用户插话后,生成、传输和播放队列都应响应取消,避免旧声音继续积压。
测试应重放相同的文本到达过程,不能用一次性输入完整文本的成绩代替双流式评估。一次完整音频的试听,无法替代这些实际交互测试。
更有价值的比较,是同一硬件和负载下,展示多个文本等待量与音频块长对应的质量、延迟和成本。
如何选择技术路线
以下是根据机制给出的选型思路,最终需要用目标场景实测。
固定播报与资源受限设备,可以优先考察计算开销可控的参数或轻量神经网络方案,并验证前端与声码器是否满足首音要求。
文本已知的朗读场景,未必需要双流式。音频输出流式就能减少等待,同时保留完整文本用于韵律规划。
接入 LLM 的语音助手与同声翻译,需要重点验证增量文本输入。外部分句适合快速接入;若对开口速度和连续韵律要求更高,可以考察原生增量或交错训练方案。
强调音色迁移、情绪与跨语言能力的应用,可以考察大规模生成模型,但应将流式能力、声音质量和部署成本分开验证。零样本能力强,不等于流式链路已经完整。
有声书与离线制作,如果不要求实时开口,可以使用更完整的上下文与后处理,把资源用于韵律和质量。
选型应先明确允许等待多少文本、用户多久必须听到首音、哪些错误不能接受,再寻找符合预算的模型与服务方式。
结语
TTS 模型一直在变,后文没有到齐时怎样生成声音,始终是流式合成要处理的问题。HMM 系统需要补齐或表示未知的上下文标签,并在有限窗口内生成声学参数;Tacotron、Transformer-TTS 等模型需要让文本编码和对齐适应增量输入,同时让声码器分块工作;采用语言模型的方案,则通过文本语音交错、注意力掩码和分块声学恢复,安排文本与声音的生成顺序。
这些设计都要为等待设定边界。多读一些后文,有助于确定发音、停顿和语气,但用户也会等得更久。已经播放的声音通常无法撤回,系统只能在提交前判断当前片段是否足够稳定。因此,缩短首音时间时,还要听后面的语音是否连贯,检查缓冲会不会耗尽,以及增加并发后能否维持同样的输出节奏。
接入 LLM 后,这些问题会沿着整条链路传递:文本何时到达,TTS 何时开始合成,客户端何时播放,都会影响用户听见回答的时间。模型输出第一块音频后,还需要继续供给;用户插话时,生成、传输和播放队列也都要及时停止。实际选型时,可以把这些环节分别测清楚,再根据场景调整文本等待量、音频块长和播放缓冲,找到声音质量、响应速度与计算成本都能接受的配置。
相关文献参考:
[1] Pouget M, Hueber T, Bailly G, et al. HMM Training Strategy for Incremental Speech Synthesis[C]//Interspeech 2015. 2015: 1201–1205.
[2] Wang Y, Skerry-Ryan R J, Stanton D, et al. Tacotron: Towards End-to-End Speech Synthesis[C]//Interspeech 2017. 2017: 4006–4010.
[3] Shen J, Pang R, Weiss R J, et al. Natural TTS Synthesis by Conditioning WaveNet on Mel Spectrogram Predictions[R]. arXiv:1712.05884, 2017.
[4] Li N, Liu S, Liu Y, et al. Neural Speech Synthesis with Transformer Network[C]//Proceedings of the AAAI Conference on Artificial Intelligence. 2019, 33(1): 6706–6713.
[5] Ma M, Zheng B, Liu K, et al. Incremental Text-to-Speech Synthesis with Prefix-to-Prefix Framework[C]//Findings of the Association for Computational Linguistics: EMNLP 2020. 2020: 3886–3896.
[6] Ren Y, Hu C, Tan X, et al. FastSpeech 2: Fast and High-Quality End-to-End Text to Speech[R]. arXiv:2006.04558, 2020.
[7] Wang C, Chen S, Wu Y, et al. Neural Codec Language Models Are Zero-Shot Text to Speech Synthesizers[R]. arXiv:2301.02111, 2023.
[8] Du Z, Wang Y, Chen Q, et al. CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models[R]. arXiv:2412.10117, 2024.
[9] Bai R H, Gu Z, Likhomanenko T, et al. SpeakStream: Streaming Text-to-Speech with Interleaved Data[R]. arXiv:2505.19206, 2025.
[10] Sheng Z, Du Z, Zhang S, et al. SyncSpeech: Efficient and Low-Latency Text-to-Speech Based on Temporal Masked Transformer[R]. arXiv:2502.11094v2, 2026.
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


