Meta 于 2026 年 11 月 5 日宣布,实时语音对话与表情虚拟形象(expressive avatars)正在美国地区的 Muse 应用中上线,覆盖移动端、网页端与 Mac,为其个人 AI 智能体增添了语音与视觉交互界面。
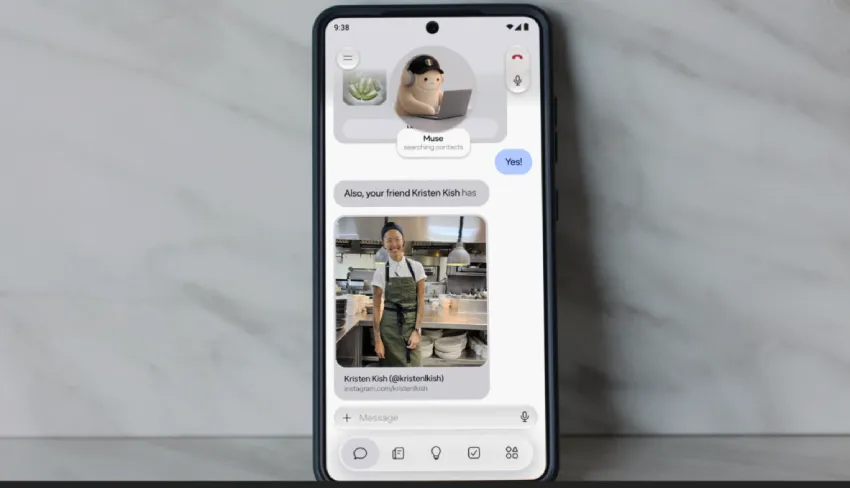
此次发布紧随 Meta 于 2026 年 9 月 23 日的 Connect 2026 预览,当时展示了长时间实时对话与 Muse Realtime Avatar。此前活动演示了这些概念,本次公告则标志着它们向用户正式推送。右上角的电话图标即可开启对话。

语音控制与后台任务
Muse Realtime Voice 提供即时语音回复,并允许用户打断智能体。在对话进行的同时,智能体可以在后台继续处理任务,使讨论与委派的工作并行推进。
官方示例集中于以下几类场景:在尚未写出精确提示词的情况下梳理一个不成熟的想法;仅凭目的地和几项偏好规划行程;排练求职面试、演示或路演。其他示例包括在散步或做饭时指派任务,Muse 会在对话进行中完成这些工作。
用户可以让交互保持纯语音,也可以把虚拟形象放在对话旁边,或切换到全屏面对面视图。虚拟形象在聆听与说话时都会作出反应,使用与语气相称的表情和手势。Meta 表示有数百种声音可选,且可以随时更换,并用“精力充沛的纽约客”风格和“海盗”风格作为示例。
语音功能扩展了一个最初围绕消息传递与任务委派构建的智能体。Meta 于 2026 年 9 月 8 日推出 Muse,可通过 Muse 应用或 WhatsApp 交互。Muse 能发送邮件、预订行程,在应用关闭后继续工作,并在出现变化或敏感操作(如购买)需要批准时回来找用户。新功能为这套既有的“任务 + 审批”模式增加了语音与视觉存在感。
实时虚拟形象背后的系统
Meta AI Research 的技术说明将 Muse Realtime Voice 与 Muse Realtime Avatar 描述为同一套流式系统。语音模型生成携带内容与表达方式的语音 token。音频解码器把这些 token 转为语音,而虚拟形象模型消费同一数据流来生成视觉表演,从而保持声音、唇动与表情同步。
虚拟形象是一个音频驱动的 Diffusion Transformer,其条件输入包括该 token 流、参考素材(如肖像或插画),以及一个滚动窗口的近期视频 latent。它生成短小的因果视频块。每生成完一块,其中最新的 latent 就为下一块提供运动上下文,把外观与习惯动作延续下去,同时限制计算量,使生成能够贯穿整场对话持续进行。
为了让这一过程可用于实时场景,Meta 报告称,通过蒸馏把每块的生成从 120 次带引导的教师模型评估减少到 2 次无引导的学生模型评估。它称这相当于 60 倍的削减,同时较好地保留了教师模型的质量。
研究团队报告的输出规格为 448×768 肖像视频、25 帧/秒,从用户话轮结束到同步语音+视频响应的首字节约 870 毫秒延迟。其优化使服务容量相对两步 BF16 基线提升八倍,并可在单块 GB200 上支持 12 路并发实时视频生成会话。延迟指标关乎对话的响应性,而容量数据关乎持续视频生成带来的服务负载。
防护措施与计划中的设备
研究文章称,生成的虚拟形象视频包含持久、不可见的 Meta Video Seal 水印,且不会增加实时延迟。文章还提醒,其示例用于说明模型能力,并非都反映 Muse 应用中可用的虚拟形象。Muse 仅面向 18 岁及以上用户。
Meta 表示,语音对话也将很快登陆 AI 眼镜与 Muse Charm。在 Connect 上,它将眼镜端的访问描述为免手操作,而 Charm 是一款口袋大小的设备,专为与 Muse 语音交互而设计。
本次发布使交互模型本身成为核心进展:语音、打断与后台任务执行如今都处于同一个会话之内,虚拟形象则增添了视觉回应。Meta 能否把这种组合延伸到 AI 眼镜与 Muse Charm,是下一个待解的问题;在应用于移动端、网页端与 Mac 推进美国地区上线的同时,这些版本仍处于计划阶段。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/zixun/73063.html


