语音识别并不总能等人把整句话说完。实时字幕要边听边显示,输入法要让文字及时上屏,语音助手要尽快判断用户是否说完,会议系统还要持续处理数小时音频。这些场景共同需要一种能力:音频不断到来,识别结果也不断产生。 这就是流式自动语音识别(Streaming ASR)。
流式 ASR 的难点不只是“算得快”,而是模型必须在看不到未来语音的条件下做判断。等待更多声音通常能提高准确率,却会增加延迟;过早输出虽然响应快,却更容易出错或反复修改。几乎所有流式技术,都在处理这组矛盾。
什么是流式 ASR
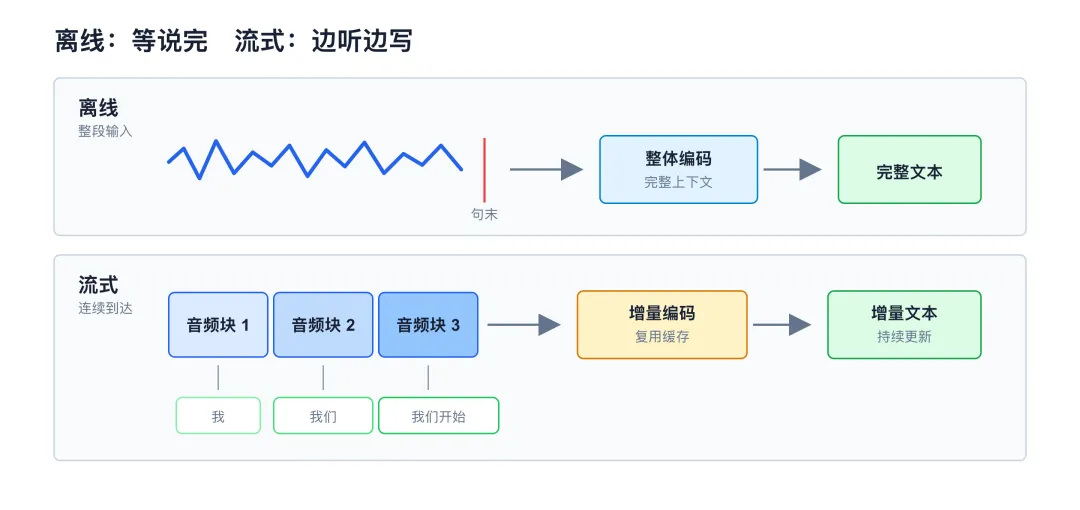
离线 ASR 先接收完整音频,再统一编码和解码。流式 ASR 将音频切成连续到达的帧或小块,每获得一部分新声音,就更新内部状态并产生增量文本。

一个真正可用的流式系统通常满足三点:
- 增量接收:不需要拿到完整音频才启动计算。
- 未来信息受限:每次预测只能使用已经到达的语音,以及事先约定的少量右侧上下文。
- 状态可复用:历史声学特征、注意力键值或解码状态可以缓存,不必每来一块音频就从头计算。
“在线”和“实时”也不是同一个概念。在线强调可以增量处理;实时强调计算速度跟得上音频速度。一个模型可以支持分块输入,却因为计算过慢而使待处理音频不断积压;也可以算得很快,但必须等整句结束才开始识别。还需要区分三种常被统称为“流式”的实现:
| 类型 | 做法 | 特点 |
| 滑窗式伪流式 | 反复截取最近几秒,调用离线模型 | 改造简单,但重复计算多,边界和回改问题明显 |
| 分块流式 | 按块编码,限制右侧上下文并缓存历史 | 工程上最常见,可调节准确率与延迟 |
| 原生流式 | 训练时就建立音频与文本的单调或同步关系 | 输出时机更可控,但训练和对齐设计更复杂 |
为什么需要流式
1. 交互不能等整句话结束
人在对话中会利用停顿、语气和对方的即时反馈调整表达。如果系统总要等数秒才出现文字或开始响应,交流会变得迟钝。流式识别可以让字幕及时上屏,也可以让下游翻译、检索和大模型推理提前启动。
2. 长音频需要有界计算
会议、直播和客服通话可能持续数十分钟甚至数小时。离线模型若始终保留并重新处理全部历史,计算量和显存占用会随音频时长增长。流式系统通过有限窗口、压缩记忆和缓存,把每一步的开销控制在相对稳定的范围内。
3. 端侧和并发服务更关心持续成本
手机、车机和可穿戴设备需要小内存、低功耗;云端服务则要同时承载大量语音流。增量计算和状态复用能避免重复编码,使吞吐、资源占用和响应速度更容易控制。
4. 语音智能需要流水线并行
现代语音产品往往不止输出文字。识别结果还会进入翻译、对话理解、摘要或智能体等下游模块。流式 ASR 让这些模块与说话过程重叠执行,降低整条链路的等待时间。
流式系统真正要解决什么
无论服务于哪种场景,流式系统都要回答两个问题:读到哪里才够?什么时候可以写?
要理解这两个问题,可以先把延迟的来源放到一条时间线上:

因此,“chunk 为 500 ms”不等于“出字延迟为 500 ms”。完整体验还受到块边界、右看、模型发射倾向、计算、网络和结果稳定策略影响。流式也不必完全因果:实际系统经常允许几十到数百毫秒的有限右看,用少量等待换取更清楚的声学边界。
无论采用哪种模型,常见工程组件都包括:流式特征提取、受限未来信息的编码器、增量解码器、历史状态缓存、稳定前缀管理,以及判断一句话何时结束的端点检测。
Hybrid 时代:解码器天然沿时间前进
传统大词汇量识别通常由声学模型、隐马尔可夫模型(HMM)、发音词典和 N-gram 语言模型组成。音频被转换为常见的 10 ms 左右一帧的特征,声学模型为每帧的音素或 HMM 状态打分;解码器使用 Viterbi 搜索,把声学得分、状态转移、词典和语言模型组合起来。

这套系统天然适合流式:每来一帧,解码器就扩展一批候选路径,保留高分路径并剪掉低分路径。WFST 把 HMM、上下文相关音素、词典和语言模型编译成统一搜索图,使在线 token passing 高效可控。
Hybrid 系统的优势是边界清楚、延迟可解释、词典和语言模型容易单独替换;缺点是模块多、训练目标分散,前面模块的错误会传给后面模块。随着 DNN、LSTM、TDNN 等取代 GMM,声学模型越来越强,但在线解码的基本逻辑没有改变:沿音频时间轴逐帧搜索。
S2S 时代:把对齐和解码交给神经网络
端到端序列模型减少了人工拆分的模块,却也带来新问题:文本比声学帧短得多,模型必须自己学习“哪个字对应哪段声音”,还要保证在线时不能看完整音频。

1. CTC:用 blank 学习单调对齐
CTC 在普通标签之外加入 blank。模型可以连续多个时刻输出 blank,表示“暂时不产生新文字”;重复标签合并、blank 删除后得到最终文本。由于语音和文字的顺序基本一致,CTC 可以在流式编码器上逐帧或逐块解码。
CTC 简洁、训练稳定、推理并行度高,但它对输出标签之间的依赖建模较弱,通常需要语言模型或更强编码器补充上下文。还要注意:CTC 损失本身不保证流式,双向编码器仍会让系统依赖未来语音。
2. RNN-T:同时听声音和看已输出文字
RNN-T(更一般地称 Transducer)由编码器、预测网络和联合网络组成。编码器表示已到达的语音,预测网络表示已经输出的文字历史,联合网络决定输出新标签还是 blank。
blank 在这里相当于“继续读音频”,非 blank 相当于“现在写一个标签”。RNN-T 因而能在不显式切词的情况下学习发射时机,并利用文字历史消除歧义。它长期是语音助手、输入法和端侧识别的重要方案。代价是训练与搜索比 CTC 更复杂,模型也可能因为偏好等待更多上下文而发射过晚,因此出现了 constrained alignment、FastEmit 等延迟约束方法。
3. Attention:把全局注意力改造成单调或分块注意力
标准 Attention Encoder-Decoder 会在生成每个 token 时查看整段编码结果,天然偏离流式需求。解决办法主要有两类:
- 单调注意力:从上次位置继续向前寻找发射点。MoChA 在选定位置附近的小窗口内做软注意力,兼顾在线性与局部表达能力。
- 分块注意力:把编码器限制在当前块、历史缓存和少量右侧上下文内。Streaming Conformer、Emformer 等通过块处理、记忆和 KV 缓存保留长历史,同时避免访问无限未来。
这一时期形成了今天仍在使用的基本配方:动态 chunk 训练适配多种延迟,缓存避免重复计算,有限右看换取准确率,发射正则减少无谓等待。
| 方法 | “等待”的表示 | 主要优势 | 主要挑战 |
| CTC | blank | 简单、高效、易部署 | 标签依赖较弱 |
| RNN-T | blank + 文字历史 | 原生增量、输出上下文强 | 训练搜索复杂,可能晚发射 |
| MoChA | 学习单调边界 | 自适应决定读写位置 | 边界学习较敏感 |
| 分块 Transformer/Conformer | chunk + 右看 + 缓存 | 表达能力强、易调延迟 | 块边界、显存和稳定性 |
大模型时代:让语言模型学会时间的流动
语音大模型通常把整段音频编码成一串“语音提示”,再让大语言模型生成文本。这种架构擅长利用长上下文、多语言和语义知识,却天然更像“听完再答”:如果全部语音提示必须放在文本之前,第一字就只能等音频结束后生成。
近年的流式 Speech LLM 大体沿四条路线演进:

| 路线 | 核心做法 | 代表性工作 | 特点 |
| 离线模型分块化 | 周期性追加音频,保留稳定前缀并回改尾部 | Qwen3-ASR 等 | 易复用离线能力,但更新粒度和回改窗口可能较大 |
| 音频文本交错 | 每收到一个音频 embedding 就尝试生成,没内容时输出 BLANK | Speech ReaLLM | 把 RNN-T 的 blank 思想带入 decoder-only LLM |
| 显式 READ/WRITE 策略 | 独立模块决定继续读还是生成 token | BESTOW、MoChA-LLM | 读写策略清楚,可学习或使用 wait-k |
| 延迟流建模 | 先对齐音频与文本流,再让文本相对音频固定延迟 | DSM、Voxtral Realtime | 原生时间同步,可直接控制目标延迟 |
这不是对旧技术的彻底替代。相反,大模型流式方法重新使用了很多经典思想:BLANK 来自 Transducer,单调边界来自在线 Attention,READ/WRITE 来自同声翻译,缓存和有限右看来自流式编码器。变化在于,语言模型现在拥有更强的文本先验和上下文能力,流式训练必须让它同时学会说什么与何时说。
大模型也带来新的风险。自回归解码的逐 token 计算可能成为瓶颈;强语言先验可能让模型在声学证据不足时“补全”内容;滑窗式方案可能反复修改已显示文字;长历史还会增加 KV cache 和并发服务成本。因此,大模型是否“支持流式”,不能只看接口能否接收音频块,还要检查未来上下文、首字时间、稳定时间、回改策略和真实服务吞吐。
怎样公平评价流式 ASR
只报告 WER/CER,无法说明流式系统是否好用;只报告 chunk,也无法说明文字何时真正出现。至少应同时观察四组指标:
| 维度 | 建议指标 | 回答的问题 |
| 准确率 | WER、CER、领域错误率 | 写得对不对 |
| 发射与稳定 | 字/词声学结束到首次输出、首次稳定输出的 P50/P90 | 多久能看到可信文字 |
| 系统效率 | RTF、单流计算时间、并发吞吐、显存 | 算不算得动 |
| 交互完整性 | 句末确认延迟、回改率、最长回改距离 | 什么时候可以放心使用结果 |

论文中常见的 target delay、chunk/right context、LAAL 和 final-token latency 描述的是不同对象,不能直接放在同一横轴上比较。最公平的做法,是让所有模型接收相同速度的实时音频,以统一的字词对齐和“首次稳定输出”规则重新测量,再画准确率与延迟的 Pareto 曲线。
工程上还应分别记录模型固有延迟与端到端延迟。前者主要由 chunk、右看和发射策略决定;后者还包含计算排队、网络传输和界面刷新。模型延迟很低,并不保证高并发服务时仍然低延迟。
如何选择技术路线
评价指标最终要回到具体场景,因为没有一种结构在所有场景都最优。
- 输入法、车载和语音助手重视低延迟、稳定前缀和端侧成本,原生流式 CTC/Transducer 及小右看的流式编码器通常更合适。
- 直播字幕和会议转写允许适度回改,更重视长上下文与全局一致性,可以采用较大的 chunk、记忆编码器或带稳定前缀的大模型方案。
- 语音智能体不仅要快,还要尽早触发理解与生成,因此 ASR 发射、端点检测和下游推理需要联合设计。
- 离线归档和高精度转写若没有实时要求,完整上下文仍然最划算,没有必要为了“流式”牺牲质量。
选择时应先确定可接受的稳定输出延迟和计算预算,再比较同一延迟下的准确率,而不是先选模型再解释延迟。
结语
流式 ASR 的本质,是在信息尚未完整时持续做出可更新的判断。Hybrid 系统靠逐帧状态搜索实现在线解码;CTC、RNN-T 和单调注意力把对齐交给神经网络;大模型则进一步尝试让语言模型理解音频与文本共同流逝的时间。
技术形态不断变化,核心矛盾始终没有变:多等一会儿通常更准,早一点输出通常更快。优秀的流式系统不是单纯追求最低 WER,也不是单纯把 chunk 调小,而是在准确率、发射时机、结果稳定性和计算成本之间找到适合场景的平衡。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


