Liquid AI 发布了 LiquidCodec,也就是其 LFM3-Audio-2B 与 LFM3-Omni-2B 模型背后的音频编解码器。LiquidCodec 是一个约 7400 万参数的流式语音分词器(tokenizer)。它把语音转换成语言模型可以预测的 token,再把这些 token 转回音频。Liquid AI 有 2 个目标:让 token 易于预测,以及让转换回语音足够快。权重已发布在 Hugging Face 上。

核心要点
- 规模: 约 7400 万参数(模型卡上为 7360 万);24 kHz 音频、12.5 Hz 帧率、12 个码本
- 运行平台: 单条 CPU 线程(在 Apple M4 Max 笔记本上以 FP32 测试);通过 Transformers 使用 CUDA GPU;面向 llama.cpp 的 Q4_0、Q4_K_M 和 Q8_0 GGUF 版本
- 性能: 在全部 8 个测试集上,对比 X-Codec 2、NanoCodec 和 Mimi,取得最佳 ViSQOL 和最低梅尔距离
- 最佳表现: 单 CPU 线程上编码约 361 倍实时(编码 RTF 0.0028,Mimi 为 0.0361)
LiquidCodec 是什么?
LiquidCodec 是 Liquid AI 的语音编解码器,可把 24 kHz 音频压缩成 12 路 token 流。根据 LFM3-Audio-2B 模型卡,每个 80 毫秒的帧变成 12 个离散 token。它取代了 Kyutai 的 Mimi——Liquid AI 曾在 LFM2-Audio-1.5B 中使用 Mimi。Mimi 拥有 9620 万参数。
LiquidCodec 如何工作?
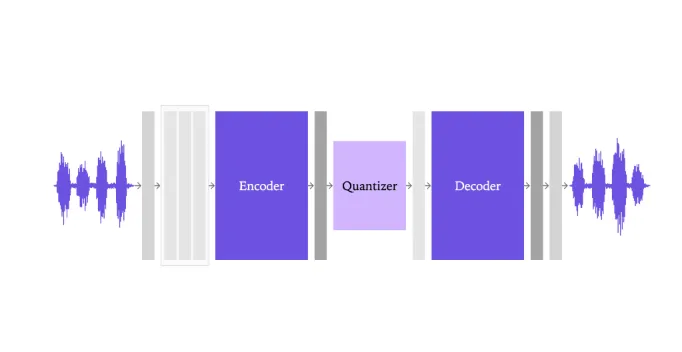
整条流水线是编码、量化、解码。Liquid AI 在编码器和解码器中都使用了其 LFM3 架构的模块。两半是对称的,且编码器完全因果(causal),很适合流式场景。
量化使用分组有限标量量化(GFSQ),而非残差向量量化(RVQ)。在 RVQ 中,每个码本编码的是前一个码本遗漏的信息。而 GFSQ 的各组相互独立,因此全部 12 个码本可以被 MaskGIT 式 Transformer 并行预测。
解码器直接预测频谱系数。这避免了学习式转置卷积上采样——那是波形解码器中常见的一项开销。
它是如何训练的?
训练分 2 个阶段。第 1 阶段使用 107 种语言、26.4 万小时的语音,采用波形损失和频谱损失,未使用对抗损失。第 2 阶段在全频带语音(24 kHz 或更高)5.5 万小时上,配合对抗判别器进行微调。Liquid AI 表示,这消除了第 1 阶段后残留的金属感伪影。最后一步是仅针对解码器的量化感知训练(QAT),面向边缘推理。
LiquidCodec 有多快?
Liquid AI 在 Apple M4 Max MacBook Pro 的单条 CPU 线程上以 FP32 测量速度。LiquidCodec 编码约为 361 倍实时,解码约为 87 倍实时。这些都是自报数据。
实时因子(RTF)是处理时间除以音频时长,因此越低越好。LiquidCodec 的编码 RTF 为 0.0028,而 Mimi 为 0.0361、NanoCodec 为 0.2145、X-Codec 2 为 0.7359。解码 RTF 为 0.0115,对比分别为 0.0329、0.2543 和 0.0379。也就是说,编码 RTF 比 Mimi 低约 13 倍,解码 RTF 低 2.9 倍。
LiquidCodec 在质量基准上表现如何?
Liquid AI 使用了 8 个测试集:LibriSpeech test-clean、Seed-TTS 英文与普通话,以及 5 种 FLEURS 语言(德语、法语、普通话、日语、韩语)。基线为 X-Codec 2、NanoCodec 和 Mimi,均使用 12 个码本。
- 重建质量: 在全部 8 个测试集上,LiquidCodec 取得最佳 ViSQOL 和最低梅尔距离。在 LibriSpeech 上,ViSQOL 为 4.319,对比 4.219(NanoCodec)、4.119(X-Codec 2)和 4.031(Mimi)。
- 文本转语音: Liquid AI 在每种编解码器的 token 上训练了完全相同的 TTS 模型。数据(10.1 万小时、6 种语言)、架构、算力和批次顺序均固定不变。LiquidCodec 在全部 8 个测试集上取得最高的 UTMOSv2,并在 8 个中的 4 个上取得最佳 WER/CER。LibriSpeech 的 WER 为 3.15%,而 Mimi 为 6.27%。换用 Qwen3-1.7B 骨干后结果同样成立,与使用 LFM3-1.7B 一致。
- 落后之处: NanoCodec 在 8 个测试集中的 7 个上取得更高的 PESQ(WB)。它还在 LibriSpeech 的说话人相似度上领先(SECS 0.836 对 0.785)。
LiquidCodec 对比 Mimi、NanoCodec、X-Codec 2
| 特性 | LiquidCodec | Mimi | NanoCodec 1.78 kbps | X-Codec 2 |
|---|---|---|---|---|
| 开发方 | Liquid AI | Kyutai | NVIDIA | 香港科技大学音频实验室(HKUST Audio) |
| 参数量 | 7360 万 | 9620 万 | 6200 万 | 8 亿 |
| 采样率 | 24 kHz | 24 kHz | 22.05 kHz | 16 kHz |
| 帧率 | 12.5 Hz | 12.5 Hz | 12.5 fps | 50 tokens/s |
| 码本 | 12 | 8(1.1 kbps) | 13 | 1 |
| 量化器 | GFSQ | RVQ | FSQ | 单层 FSQ |
| 码率 | 未披露 | 1.1 kbps | 1.78 kbps | 未披露 |
| 因果性 | 编码器因果;解码器未披露 | 完全因果 | 非因果编码器,因果解码器 | 未披露 |
| 许可证 | HF 上为 “other”;博客指向 LFM License | CC-BY 4.0 | NVIDIA Open Model License | CC-BY-NC 4.0 |
| 编码/解码 RTF,M4 Max CPU* | 0.0028 / 0.0115 | 0.0361 / 0.0329 | 0.2145 / 0.2543 | 0.7359 / 0.0379 |
| LibriSpeech 梅尔距离*(越低越好) | 0.120 | 0.160 | 0.122 | 0.123 |
| LibriSpeech PESQ(WB)* | 2.640 | 2.615 | 2.942 | 2.434 |
| LibriSpeech TTS UTMOSv2* | 3.31 | 2.89 | 3.19 | 3.27 |
由 Liquid AI 在其 LiquidCodec 博客中测量。Mimi 按 12 个码本测量。
开发者如何部署 LiquidCodec?
该编解码器可通过 Hugging Face Transformers 以 trust_remote_code=True 加载。调用 encode() 获取音频编码,调用 decode() 获取波形。根据模型卡,原生 LiquidCodecStreamingCache 支持逐块解码。模型卡中的示例使用 CUDA 加 bfloat16。
面向边缘场景,Liquid AI 列出了用于 llama.cpp 的 Q4_0、Q4_K_M 和 Q8_0 GGUF 版本。GGUF 仓库随 LFM3-Audio-2B 和 LFM3-Omni-2B 一同发布。Q4_0 配合仅解码器的 QAT,可将解码器体积缩小 3.5 倍。LibriSpeech ViSQOL 仅从 4.319 微降至 4.292。
更多详情请查看技术博客。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/73208.html


