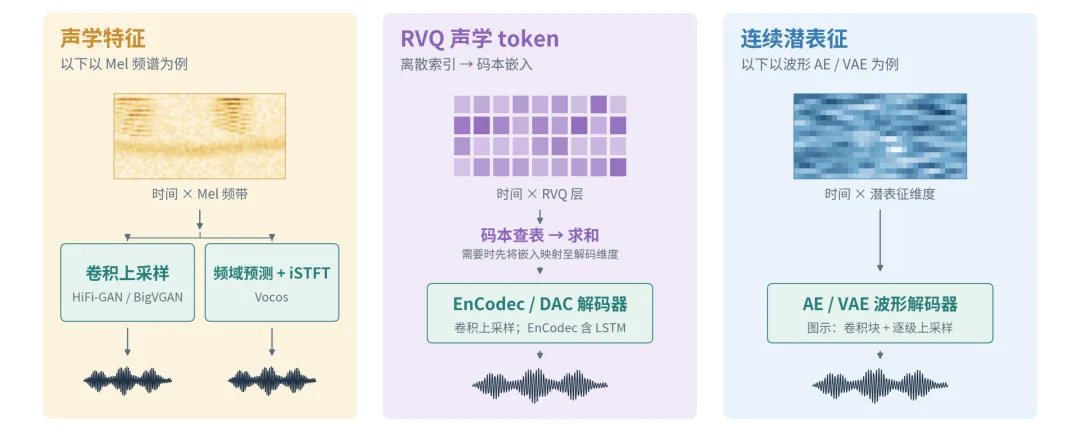
音频解码器的基本任务,是将给定的音频表征转换为时域波形。它的输入形式有很多:可以是 Mel 频谱、倒谱或音高等声学特征,也可以是离散音频 token 对应的码本嵌入,或由自编码器(AE)、变分自编码器(VAE)学习得到的连续潜表征。这种波形重建能力通常首先通过重构训练获得:从真实音频中提取或编码表征,再训练解码器依据这些表征合成音频。
本文从重构训练出发,首先介绍声码器、离散神经音频编解码器和连续音频自编码器的典型结构,说明波形重建能力如何通过重构训练建立。在此基础上,讨论生成模型如何复用这些表征与解码器,以及基于 DiT 的级联声学生成的设计思路。最后,介绍流式解码和针对预测表征的解码器微调适配。
重构训练:建立从表征到波形的重建能力
重构训练以真实音频为依据,学习如何从音频表征中重建波形。对声码器而言,输入条件通常是预先定义的声学特征;对音频自编码器而言,表征由编码器学习得到,波形重建与信息压缩共同优化。重构质量既取决于表征保留了哪些信息,也取决于解码器能否利用这些信息生成自然、清晰的音频。
声码器从声学特征中重建波形
Mel 频谱是现代 TTS 系统中广泛使用的条件,能够提供较直接的时频结构,但它没有保留相位,频带聚合也减少了频率细节。声码器通过频谱重构、对抗训练或概率生成目标,学习从这些声学特征中重建出高保真的波形。
HiFi-GAN 通过转置卷积逐级上采样,并使用多感受野残差模块建模不同尺度的波形结构。多周期与多尺度判别器参与训练,推理时由卷积生成器一次前向计算输出波形。
BigVGAN 在卷积声码器中引入周期激活和抗混叠多周期模块,并扩大生成器规模,以改善跨说话人、语言及音频域的泛化。它延续单次前向的合成方式,将改进重点放在周期信号建模和网络结构上。
Vocos 预测傅里叶谱系数,再通过逆短时傅里叶变换(iSTFT)恢复波形,减少在高采样率时域中进行上采样的开销。这里的频域预测描述输出参数化方式;论文也验证了以离散编解码器重建的嵌入为条件的合成。
DiffWave 以 Mel 为条件,在波形域通过多步扩散采样生成音频。它直接建模条件波形分布,说明最终的声码器也可以采用概率生成模型。
LPCNet 使用 18 维 Bark 尺度倒谱和两个音高参数,将线性预测与循环神经网络结合;NSF 的原论文实验则以 60 维 Mel 广义倒谱系数(MGC)和基频为条件,通过激励生成与神经滤波合成波形。这些方法说明声码器的输入并不限于 Mel 频谱,倒谱、音高等参数也可以作为合成条件,其中 MGC 并非 Mel 频谱。
离散神经音频编解码器同时学习表征与波形重建
编码时,编码器先将音频映射为连续特征,再由量化器将其转换为离散 token;解码时,通过码本查表得到嵌入,再交给波形解码器。对于残差向量量化(RVQ),不同量化层逐级描述残差,重建的嵌入在必要的维度映射后相加。
EnCodec 采用 RVQ,将多层 token 对应的码本嵌入相加,再通过包含卷积、LSTM 和上采样模块的解码器恢复波形。其训练结合时域、频域重构目标与对抗损失,以兼顾压缩与感知质量。
DAC 同样采用卷积编码器—RVQ—解码器结构,将周期激活、改进的码本学习以及多尺度频谱与对抗训练结合,提高通用音频的压缩重构质量。比较这类模型时,需要同时说明码率、码本数量和编码配置,才能判断表征压缩与波形重建各自的影响。
连续音频自编码器保留连续潜表征
AE/VAE 通过编码器压缩音频,解码器从连续潜表征恢复波形。AE 不要求潜表征服从特定分布;常见 VAE 则进一步通过高斯后验和先验正则约束潜空间。
Stable Audio 2 所用的波形 VAE 将 44.1 kHz 双声道音频压缩为约 21.5 Hz、64 维的连续潜表征,再通过卷积解码器重建波形。这类模型通过重构训练建立高压缩率表征及其解码能力,为后续潜空间生成提供基础。

编解码器模型的训练条件来自真实音频,不包含生成模型的预测误差,但在特征提取、压缩或量化过程中仍可能丢失信息。重构训练的作用,是在给定表征与压缩约束下建立波形重建能力;当生成模型能够预测相同形式的表征时,这种能力就可以被直接复用。
用于音频生成:已有解码器的复用与级联扩展
生成模型可以将重构阶段的表征作为预测目标。
训练时,从真实音频中提取声学特征,或使用已经训练好的编码器得到 token、连续潜表征,再学习它们在文本、参考音频等条件下的分布。推理时,上游生成模型产生这些表征,随后调用配套的波形解码器。这样,已有解码器就可以承担生成系统中的波形合成,而不必为每个上游生成模型重新训练一套。
VALL-E 以 EnCodec 的多层声学 token 为预测目标,生成后复用其解码器恢复波形。Parler-TTS 的官方实现则使用 DAC,将语言模型预测的多码本 token 转换为音频。
F5-TTS 通过流匹配生成 Mel,再使用预训练的 Vocos 合成波形。这里的目标表征来自固定的频谱分析过程,同样可以复用已经训练好的波形解码能力。
Stable Audio 2 在波形 VAE 的连续潜空间中训练 DiT,推理时通过 VAE 解码器将生成潜表征转换为音频。Stable Audio Open 延续了潜空间生成与波形 VAE 相结合的总体设计。
DiTAR 使用 40 Hz、64 维的波形 VAE 潜表征,以自回归模型和局部扩散模块生成潜表征片段,再交给采用 BigVGAN 风格架构的 VAE 解码器。潜空间生成与最终的波形重建由不同模块承担。
表征的重构能力与可预测性需要共同考虑。多层声学 token 保留了较多语义内容、音色和细粒度声学属性,但是较长的序列也会给生成模型的学习带来压力。连续潜表征可以通过时间维度的降采样压缩序列长度,但帧率和特征维度仍需在信息保留、生成难度与计算量之间取舍。
为了便于生成,也可以选择更强调内容或语义结构的表征。 例如,语音识别任务中学习的语音 token 更重视语言内容,而不以保留全部波形细节为训练目标。此时,从给定 token 表征直接重建波形仍存在较大不确定性,可以通过条件声学生成模型 DiT,先生成 Mel 或声学潜表征,再交给已有的配套波形解码器。
CosyVoice 从监督语音识别表征中学习 S³ token,通过条件流匹配生成 Mel,再使用 HiFT-GAN 合成波形。CosyVoice 3 采用多任务监督的语音 tokenizer,并使用 DiT 作为流匹配骨干;官方发布配置配套 Causal HiFT 波形解码器。
IndexTTS2 将语义 token 与 GPT 隐状态等条件共同输入流匹配 DiT,生成 Mel 后由 BigVGAN v2 重建波形。额外的上下文特征用于改善富表现力语音中的发音稳定性。
LeVo 以人声、伴奏双轨 token 为条件,通过 DiT 生成 25 Hz、64 维的波形 VAE 潜表征,再由 VAE 解码器输出 48 kHz 双声道音频。其 token 保留了音乐结构与声学信息,DiT 和 VAE 解码器共同构成 Music Codec 的解码部分,并被歌曲生成模型复用。
ARDiT 展示了连续潜表征的级联解码:它采用具有变分瓶颈的 Mel 自编码器,通过 DiT 流匹配解码器从潜表征生成 Mel,再由 BigVGAN 合成波形。因而,连续表征也可以采用级联结构,具体取决于自编码器建模的是波形还是中间声学特征。

从已有表征直接合成波形,或先生成中间声学表征再合成波形,都是生成模型完成波形合成的不同方式。后者将声学细节的条件生成交给 DiT,使上游预测与音频重建能够分别优化。
流式解码:在时延约束下持续输出波形
在实际应用中,音频解码往往需要满足时延要求,因此需要流式解码。流式解码要求模型在获得部分条件后就能输出可播放的音频,并随着后续条件到达持续合成。为此,解码器需要控制对未来信息的依赖:严格因果模型只使用当前与历史条件;有限前视模型允许访问少量未来条件;分块模型按块组织计算,也可以在块内使用双向上下文。
EnCodec 的 24 kHz 单声道版本采用可流式执行的编码—解码结构,通过因果填充控制卷积的时间依赖,并在转置卷积中保留需要由下一帧补全的输出状态。音频表征逐步到达时,解码器即可增量恢复波形,体现了神经编解码器对实时重构的支持。
CosyVoice 3 将流式执行扩展到级联语音合成:token 经支持分块计算的 DiT 流匹配模块生成 Mel,再由 Causal HiFT 增量合成波形。官方实现同时配置了分块注意力、有限前视和声码器右上下文,因此声学生成与波形解码两个阶段都需要满足连续输出的要求。

历史状态缓存、上采样边界对齐和适当的重叠处理,有助于减少重复计算并保持块间连续性。对扩散或流匹配模块,还需要控制采样步数和每块计算量。减少采样步数降低的是计算开销,而限制前视和块长减少的是条件等待,二者共同影响实际时延。
流式解码将整段音频的合成转变为持续推进的过程:表征逐步到达,解码器随之输出新的波形片段。因果结构与有限前视用于控制等待,状态缓存和边界处理维持片段之间的连贯性,使高质量音频合成能够用于实时交互。
生成预测微调:让解码器适应预测表征
在直接复用之外,一些研究进一步针对生成模型的预测表征微调解码器。这是因为,解码器训练时接收的是真实音频提取或编码的表征,推理时接收的却是模型预测的表征。预测 Mel 的过平滑、连续潜表征的局部偏差或分布不匹配,都可能转化为波形失真。
针对预测表征微调解码器,可以减小这种条件变化带来的质量损失。 训练时,将上游模型的输出交给解码器,并依据波形重构与感知目标更新参数,使其适应实际生成条件。对于能够联合优化的生成器与解码器,也可以通过端到端微调协调两个阶段。
HiFi-GAN 使用 Tacotron 2 在 teacher forcing 模式下预测的 Mel 微调后,V1 的 MOS 从 3.91 提升至 4.18;与此同时,输出波形的 Mel 与输入预测 Mel 的谱差增大。这说明改善听感有时需要解码器偏离预测条件中的失真,而非严格复现它。
MeanTok 针对单步流模型(mean-flow)生成的潜表征进行适配,在 24 维设置中,仅微调 VAE 解码器便将 MOS 从 3.35 提升到 3.70,联合微调生成器与解码器则达到 3.85。两种方式均保持原有推理结构,不增加推理阶段数。

这类方法将优化目标从真实编码表征上的重构,进一步延伸到生成模型实际提供的有偏预测条件。其效果需要在对应的生成模型预测分布上验证,也可以结合具体潜表征扰动或 token 错误评估鲁棒性。
结语
重构训练为音频解码器建立了可复用的波形重建能力。生成模型将声学特征、离散 token 或连续潜表征作为预测目标,便可以利用这些解码器完成音频合成;当表征更侧重语义内容时,还可以通过条件声学生成与波形解码的级联进一步提升重建效果。
从重构到生成,解码器的设计既要关注表征压缩与重构保真度,也要关注生成条件下的表现和流式输出能力。更紧凑的表征、更有效的声学建模、有限上下文下的连续合成,以及面向预测表征的解码器微调,共同决定了最终波形生成的质量与效率。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


