旧金山语音 AI 公司 Bland 已发布 Tofu-1,这是一款处于研究预览阶段的全双工语音到语音模型。Tofu-1 的目标场景是行驶中的汽车、医院病房和信号微弱的线路上的通话。它一边说话一边聆听,一边对话一边思考。对电话智能体团队来说,现在一个模型就能处理音频输入和音频输出,中间不再需要转写文本。

Tofu-1 是什么?
Tofu-1 是 Bland 推出的全双工语音到语音模型,能在电话通话过程中直接以音频完成“听、思考、回复”。它是 Bland 计划中的语音到语音模型家族的首个发布版本。
Tofu-1 与级联式语音智能体有何不同?
大多数语音智能体采用级联架构:先把语音转成文本,交给语言模型处理,再把回复转回语音。Tofu-1 直接聆听音频,因此语气、犹豫、背景声等信息都能保留给模型使用。Bland 未公开其内部架构。
音频理解能力
Bland 在产品页面上列出了 3 项音频能力:
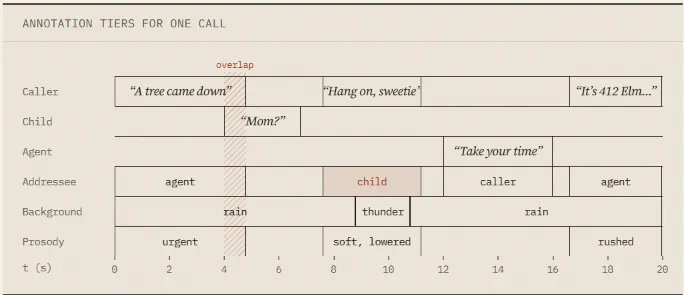
- 说话人追踪:区分不同说话人,并判断每个人在对谁说。
- 噪声分离:把语音从哭闹的孩子、电视、高速公路车流、医院对讲机或按键音中分离出来。
- 副语言信息:听出犹豫、沮丧和急迫的情绪。
全双工与“边说边想”
通话者可以在 Tofu-1 说到一半时打断或纠正它。在处理请求的同时,它会让对话继续推进;只有任务真正完成后才报告结果,绝不提前声称任务已完成。
场景生成
由于 Tofu-1 对通话声音进行了建模,它也能生成通话声音,包括第二位说话人、其周围的空间环境以及线路噪声。
什么是 Bland 的“电视测试”?
电视测试只问一个问题:模型能否在忽略另一场景语音的同时,跟住通话者?电视音频往往比通话者更响。Bland 标注其电视测试演示为示意性内容,并非模型实录输出。
Tofu-1 与其他全双工模型对比
| 特性 | Bland Tofu-1 | OpenAI GPT-Live-1 | NVIDIA NemotronLabs VoiceChat 11B | Block Dessa |
|---|---|---|---|---|
| 类型 | 全双工语音到语音 | 全双工语音模型 | 全双工语音到语音 | 全双工语音到语音 |
| 参数量 | 未披露 | 未披露 | 11B | 未披露 |
| 权重 | 闭源 | 闭源 | 开源(OpenMDW 1.1) | 未发布 |
| 训练数据 | 数百万小时真实对话 | 未披露 | 约 55 万小时音频加文本 | 仅人类语音,无文本 |
| 硬件 | Bland 托管 | OpenAI 托管 | A100、H100、H200、B100、B200、RTX-6000 | MacBook Pro M4 Max 及以上 |
| 轮次切换延迟 | 未披露 | 0.798 秒(FDB v1) | 448 毫秒(FDB) | 未披露 |
| 工具调用 | 一边工作一边继续说话 | 委派给后端模型 | 实时工具调用,82.5% 工具选择准确率(FDB v3) | 未披露 |
| 获取方式 | 企业研究预览 | API 与 ChatGPT | Hugging Face 检查点、NVIDIA 容器 | 面向安全研究者的研究预览 |
竞品数据来自各厂商自己的页面。FDB 结果使用了不同的基准版本,不能直接比较。
如何获取 Tofu-1?
研究预览仅向有限数量的企业开放。Bland 将银行、医疗、保险和政府列为目标行业。报名表单要求填写月度通话量,选项从不足 1,000 次到 50,000 次以上。
要点总结
- Tofu-1 是 Bland 的首个全双工语音到语音模型,专为嘈杂通话环境打造。
- 它直接聆听音频:说话人、背景噪声和通话者情绪。
- 唯一公布的数字是自报数据:在筛测中超过 92% 的人无法辨认出它是 AI。
- 尚无参数量、延迟、定价或基准测试;竞品则公开了延迟和工具调用得分。
- 访问方式是封闭的企业预览,Bland 称将于 1 月开放。
更多详情请查看Tofu-1 产品页面。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/73236.html

