总部位于波士顿的Modulate公司已筹集了 2500 万美元的新资金,该公司希望利用 AI 领域日益严峻的挑战:教会机器不仅理解人们说了什么,还要理解他们是如何说的。
Future Ventures 领投了本轮融资,Hyperplane 和 Lakestar 也参与了投资。此次融资使 Modulate 的总融资额达到 6000 万美元,资金将用于拓展其 AI 研究、工程团队、开发者工具、合作伙伴关系以及部署方案。
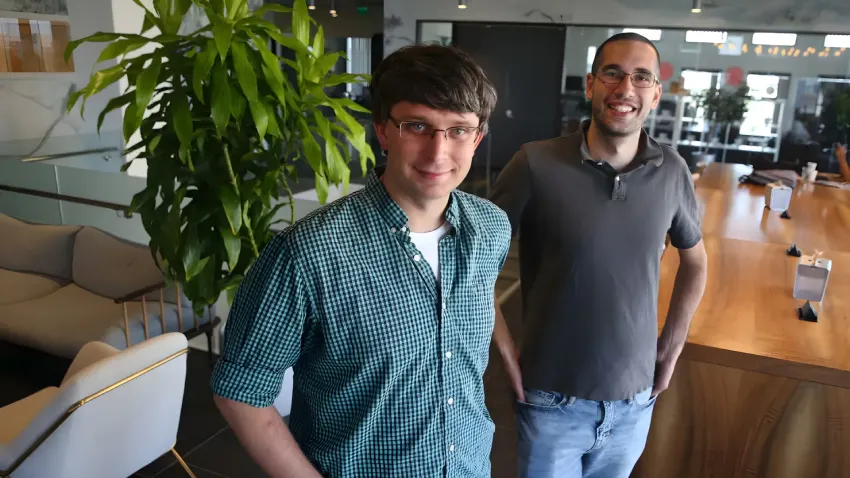

随着语音越来越多地成为 AI 代理、客户服务平台、游戏环境和安全系统的交互界面,这项投资应运而生。虽然语音转文本技术已经取得了显著进步,但 Modulate 认为,仅凭文字转录无法完整呈现人类语音中包含的大量信息。
它的技术不是分析音频,而是分析音频中的情感、语气、意图、停顿、合成语音和对话行为等信号。
超越语音转文本
当今的语音 AI 技术栈大多遵循相对简单的架构:将语音转换为文本,然后将生成的文本转录发送到大型语言模型 (LLM)。
当词语本身包含大部分相关信息时,这种方法效果很好。但如果含义依赖于讽刺、沮丧、犹豫、紧张、打断或语气变化,这种方法就会受到限制。
Modulate 的旗舰平台 Velma 的核心理念是,应该直接从音频中分析这些信号,而不是事后从转录文本中重建这些信号。
该公司将Velma描述为一个原生音频对话智能系统,能够在生成文本记录的同时识别说话人、情绪、对话主题、情感倾向以及超过150种行为。开发者还可以使用自然语言描述来定义自定义行为。
这使得该技术可以应用于各种场景,例如在通话恶化之前识别沮丧的客户,在金融交易中检测可疑行为,或者识别 AI 语音代理何时出现异常行为。
今年 6 月,Modulate 通过 API 直接向开发者开放了 Velma,使其访问权限超越了之前的企业部署范围。
Modulate 采用了一种集成式音频人工智能方法
Velma 的底层架构是 Modulate 所称的“集合聆听模型”(Ensemble Listening Model,简称 ELM)。
ELM 不是使用一个庞大的模型来执行所有任务,而是协调 100 多个专门的模型,每个模型的各个组件分析音频流的不同特征。
这些模型可以分析诸如说话人变化和停顿等基本属性,以及诸如情绪、感知意图、合成语音标记、困惑或行为模式等更高层次的信号。然后,编排层会将这些观察结果整合起来,从而对对话进行更广泛的解读。
这与将越来越大的多模态基础模型应用于音频的日益普遍的策略有着明显不同的理念。
Modulate认为,专业化使其架构能够在减少计算量的同时,提供更透明的输出。对于欺诈检测和合规性等企业应用而言,了解系统发出警报的原因几乎与警报本身同等重要。
该公司表示,对于某些音频分析工作负载,这种方法的计算效率比使用单个大型模型高出 1000 倍。
语音 AI 引发新的监控问题
此次融资的时机也反映了企业 AI 领域正在发生的更广泛的转变。
AI 系统越来越能够与客户进行完整的语音对话。这意味着企业现在不仅要监控涉及人类员工的互动,还要监控涉及自主代理的互动,这些互动可能涉及成千上万甚至数百万次对话。
语音代理虽然技术上可以按照脚本进行操作,但仍然会反复打断客户,无法识别客户的沮丧情绪,误解客户的意图,或者对情绪化的情况反应不佳。
Modulate 看到了成为与这些代理并肩工作的独立监听层的机会。
它的语音代理技术旨在识别诸如中断、停顿、情绪、口音和其他仅凭文本难以捕捉的特征等信号,使开发人员能够在对话仍在进行时调整代理的行为。
同样的架构也可以应用于人际对话,组织可以在对话中实时识别欺诈、合规风险、骚扰或其他潜在的重大事件。
从游戏管理到更广泛的语音智能
Modulate 目前的发展目标与其早期专注于在线游戏相比,标志着业务范围的显著扩展。
该公司最知名的产品之一 ToxMod 旨在分析游戏和社交平台上的实时语音通信,并识别骚扰、威胁、诱骗和其他有害行为。
这仍然是业务的重要组成部分。Modulate公司表示,ToxMod可以直接与现有的语音基础设施集成,同时将可能存在问题的互动路由到审核系统或人工审核员。
该公司曾与包括动视、拳头游戏、Rockstar Games 和 Rec Room 在内的多家大型游戏公司合作。
但是,理解多人游戏中毒性行为所需的底层技术也可以应用于其他注重情境的环境。
Modulate 目前将其技术应用于欺诈预防、联络中心、AI 代理监管、深度伪造检测、客户体验以及信任和安全等领域。
其开发者平台目前提供多种模型系列,涵盖转录、深度伪造检测、音频编辑、对话智能和其他音频分析功能。
深度伪造技术为直接理解音频提供了又一理由
合成语音正成为这一机遇的另一个重要组成部分。
随着越来越逼真的语音克隆技术出现,处理金融交易或敏感信息的机构不仅需要确定来电者说了什么,还需要确定声音本身是否真实。
因此,Modulate 已扩展到深度伪造检测领域,将合成语音分析与其音频模型提供的更广泛的上下文信息相结合。
该公司表示,其技术目前每月可分析超过 1000 万小时的音频,总共已处理超过 6 亿小时的音频。
其在 AI 生成音乐检测等领域的拓展也表明,其底层集成架构具有广泛的应用潜力。例如,Modulate 的音乐检测系统会分别评估音乐、AI 生成的人声和 AI 生成的乐器声,然后再将这些信号组合成一个可解释的结果。
语音 AI 的下一个挑战是理解,而不是说话
这笔 2500 万美元的投资将为 Modulate 提供更多资源,用于拓展其研究、工程、开发者工具和合作伙伴关系。更广泛地说,这反映了语音 AI 面临的一个日益严峻的挑战:自然地说话仅仅是对话的一半。
随着语音代理进入客户服务、医疗保健、金融服务和其他领域,系统需要理解转录文本经常遗漏的信号,包括沮丧、犹豫、强调、语气和可能的合成语音。
这可以为语音交互创建一个新的智能层,帮助系统检测欺诈行为,识别客户何时不满意,或识别人工智能代理何时误解或处理不当对话。
但这项技术也引发了关于隐私、准确性和偏见的担忧。从语音中推断情绪或意图比转录文字更加主观,尤其是在不同的口音、语言和文化背景下。
随着 AI 越来越能够像人一样说话,下一个前沿领域可能是确定机器的聆听能力究竟如何,以及如何负责任地使用这些能力。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


