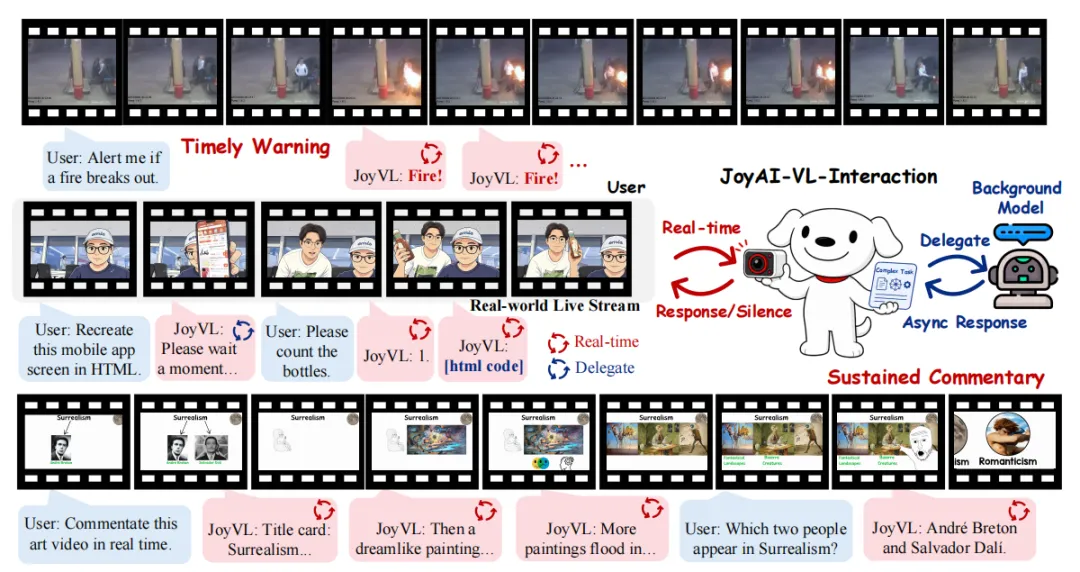
实时视频交互不仅要求模型理解画面,还要求模型在恰当的时刻作出回应。传统轮次式视觉语言模型主要围绕用户提问生成回答,难以持续跟踪事件并主动判断何时应当发言。针对这一问题,本文提出了以视觉为驱动的8B规模交互模型与系统 JoyAI-VL-Interaction。模型持续接收视频流,并在每秒的决策中选择回应、保持沉默或将复杂任务委派给后台模型。在报告所设定的六类真实场景、58个案例中,JoyAI-VL-Interaction 相较豆包和 Gemini 视频通话功能的人类偏好胜率分别为77.6%和87.9%,展示了将交互时机作为独立能力进行训练的价值。
文章来源:京东探索研究院技术报告
论文题目:JoyAI-VL-Interaction: Real-Time Vision-Language Interaction Intelligence
论文作者:Dingyu Yao, Junhao Zhou, Chenxu Yang, Chuanyu Qin, Haowen Hou, Zheming Liang, Congcong Wang, Yuhang Cao, Shenglong Ye, Shuai Xie, Shuhuan Gu, Haoyang Huang, Qingyi Si, Nan Duan, Jiaqi Wang
原文链接:https://arxiv.org/pdf/2606.14777
项目链接:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction
代码链接:https://github.com/jd-opensource/JoyAI-VL-Interaction
内容整理:凌清悦
一、概述
当监控画面中有人摔倒、直播中出现目标商品,或比赛中发生一次得分时,有效的助手需要持续观察,在事件发生时及时提醒用户。对于这类任务,回答是否正确与是否在合适的时候回答同样重要。
传统视觉语言模型(Vision-Language Model,VLM)通常采用“用户提问—模型回答”的轮次式交互。即使模型能够快速理解当前画面,也不意味着它能持续执行“帮我盯着这个场景”的任务。以字幕翻译为例,用户希望模型跟随视频不断翻译新字幕,而轮次式系统可能只回答提问时看到的内容,随后结束这一轮交互。
已有方案分别从低延迟多模态生成、周期性请求和流式视频理解等方向改进体验,但持续感知、主动响应、长时记忆与可部署系统之间仍需要协同设计。论文据此提出,交互能力需要作为模型自身的能力进行训练 :模型既要理解当前发生了什么,也要结合用户意图与历史上下文判断,此刻是否值得作出回应。

JoyAI-VL-Interaction 围绕这一目标构建了模型与系统两部分。模型负责每秒的交互决策,系统负责视频接入、语音转换、记忆维护和后台任务执行。语音识别与合成作为可替换的输入输出模块,使交互模型能够集中学习视觉事件与响应时机之间的关系。
二、模型与训练方法
将回应、沉默与委派纳入模型决策
JoyAI-VL-Interaction 基于 JoyAI-VL 1.0 构建,语言模型初始化自 Qwen3-8B,视觉编码器采用 Qwen3-VL 的视觉 Transformer(Vision Transformer,ViT)。在基础视觉语言能力之上,模型进一步学习面向连续视频流的交互策略。
在默认每秒一次的决策节奏下,模型结合新到达的视觉信息、用户需求及历史上下文,选择以下行为:
- 回应 :通过
</response>开始输出,在事件出现或任务需要时向用户提供信息。 - 保持沉默 :输出
</silence>,继续观察,避免在缺乏新信息时反复打扰用户。 - 委派 :在回应中使用
</delegation>标记,将需要较长推理或外部工具的任务交给后台处理。
沉默具有明确的监督目标。例如,用户要求“有人摔倒时提醒我”,模型在正常画面中应持续保持沉默,在目标事件发生时才发出提醒。持续观察期间不说话,同样属于正确完成任务的一部分。委派则使实时交互与复杂问题求解能够同时进行。模型可以先向用户说明正在处理,再发送后台请求;等待结果时,仍然继续观看视频并处理新的交互。后台返回后,模型再结合当前上下文组织回应。
AdaCodec:用紧凑表征支撑持续观看
持续输入视频会带来不断增长的视觉 token 开销。逐帧编码 RGB 图像时,相邻画面中重复的背景和物体也会被反复送入语言模型。JoyAI-VL-Interaction 引入的 AdaCodec 借鉴预测编码思想,在视觉信息进入语言模型之前减少时间冗余。

AdaCodec 将采样视频组织为图像组(Group of Pictures,GOP):参考帧保留完整的 RGB 视觉表征;可预测的中间帧则通过运动向量与预测残差表示,再由专门的 P 帧分词器生成紧凑 token。图2所示配置中,完整帧对应256个视觉 token,而预测帧仅使用16个。当预测代价升高或达到预设长度上限时,系统刷新参考帧,避免持续沿用不可靠的预测。
与面向播放的视频压缩不同,AdaCodec 优化的是视频大模型的视觉输入表征,目标是在减少 token 的同时保留理解时序变化所需的信息。关于其编码与训练细节,可参阅 AdaCodec 原论文。
时间对齐数据:同时标注说什么与何时说
论文构建了超过400万条时间对齐的流式交互片段。与普通视频问答数据相比,这类数据不仅给出回答内容,还明确回答应该出现在哪个时刻,以及哪些时刻应保持沉默。
(1)主动告警与异常检测 模型应在目标事件出现前保持沉默,并在事件发生时及时告警,标注重点是准确定位触发时刻。
(2)时间对齐问答 这类数据覆盖回溯、当前和前瞻三种情况:问题在证据出现后提出时,模型需要依据历史信息回答;问题与证据同时出现时,应结合当前画面回应;问题先于证据出现时,则需要持续等待,直到相关信息出现再回答。
(3)实时计数与时间感知 计数任务要求模型持续跟踪重复出现的物体或事件,时间感知任务则要求模型遵守明确的时间条件,两者共同训练模型在连续视频中维护状态,并按事件或时间条件触发回应。
(4)实时解说与旁白 模型既要描述正在发生的内容,也要把握发言和停顿的节奏。从真实解说与转播素材中提取语音内容,使训练数据保留自然的表达风格和停顿规律,帮助模型学习何时值得补充信息、何时应继续观察。
(5)多轮随意聊天 数据覆盖随视频展开的日常交流、跨较长视频的多轮对话和陪伴式聊天。与单轮问答相比,模型需要同时跟随画面变化与对话进展,保持上下文连贯。标注重点是让每轮回答与其对应时刻的视觉信息一致,避免模型讨论的内容逐渐偏离当前画面。
(6)委派场景 委派数据可以穿插在上述场景中,训练模型识别需要后台协助的复杂问题。每条数据包含完整过程:识别任务、向用户给出过渡回应、提交后台请求、继续处理视频流,最后结合返回结果回答。数据构造时引入随机后台延迟,使模型在等待期间仍能响应新问题,或在没有必要发言时保持沉默,从而学习实时交互与后台任务并行的行为。
监督微调与强化学习
监督微调 将时间对齐交互数据与常规轮次数据混合使用。由于视频中的大多数时刻不需要发言,沉默标签远多于回应标签,直接使用标准损失容易使模型偏向持续沉默。因此,论文对时间对齐数据采用按 token 角色加权的交叉熵损失:

其中,A 为参与监督的助手 token 位置集合,wj 为对应权重。一段连续沉默中的首个 </silence> 权重为1,后续重复沉默的权重降为0.4;</response> 的权重提高至1.5,其余位置权重为1。这样既保留必要的沉默监督,也增强开始回应的学习信号。常规轮次数据仍使用标准 SFT 损失。
强化学习 在 SFT 之后采用组相对策略优化(Group Relative Policy Optimization,GRPO),进一步优化流式交互中的决策。奖励同时考虑内容和时机:正确且在合适时间窗口内给出的回答、必要的沉默以及合理的委派获得奖励;无依据的发言或委派、过早或过晚的回应,以及始终输出回答的行为受到惩罚。
这一训练过程将“会使用交互动作”进一步推进到“在恰当时刻使用交互动作”。对于委派,模型还需要学习哪些问题应自行回答、哪些应交给后台,以及如何在结果返回后继续完成用户任务。
三、实时交互系统
实时循环与异步循环

系统围绕两个并发运行的循环组织。
实时循环 持续接收摄像头或 RTSP 视频流,将采样画面与用户输入送入交互模型。模型每秒判断是否回应;需要发言时,文本可以通过流式语音合成模块播放。
异步循环 处理被委派的复杂任务。后台可以接入外部大模型、智能体或 API,在较长时间内执行推理或工具操作,而前台交互模型继续跟随当前视频。
两条循环通过委派桥接模块连接。后台任务具有超时处理机制;返回时,系统将限定长度的结果摘要纳入交互上下文,完整代码等产物保留在上下文之外,以控制输入规模。
分层记忆支持长时间交互
仅降低单帧 token 数量仍不足以无限保留视频历史。系统进一步采用分层记忆(Hierarchical Memory),根据时间跨度逐级压缩信息:
- 短期记忆 保存最近一段视频的原始视觉 token,用于理解当前场景与近期变化。
- 中期记忆 将较早的短期片段转为文本摘要,保留此前发生的事件。
- 长期记忆 进一步合并和压缩中期摘要,以较小的上下文开销覆盖更长时间。
对话记忆独立维护历史问题与回答,帮助模型保持交互的时序一致性。各级记忆的合并异步执行,避免阻塞实时推理。文本摘要还能形成较稳定的上下文前缀,与 vLLM 的键值缓存(KV Cache)复用配合。每一步主要计算新到达的视觉信息和最新交互,而不必反复处理完整历史。
可替换的语音与界面组件
自动语音识别(Automatic Speech Recognition,ASR)与文本转语音(Text-to-Speech,TTS)只承担模态转换,交互决策由模型完成。部署者可以按语言、声音风格和算力需求替换这些模块。
系统也考虑了语音输出的实际时长:当上一句仍在播放时,后续句子可以仅显示文本,避免连续生成的回答在语音端积压。可视化界面则提供视频源选择、采样配置、对话历史及延迟显示,方便观察系统如何跟随视频作出决策。
推理服务与运行时
为了在长时间视频输入下保持实时响应,系统围绕 vLLM 组织推理服务,并配套维护会话状态与运行时调度机制。
服务端会话管理 服务端按会话标识维护视频上下文、问答历史和记忆状态,并在组装请求时自动注入所需上下文。客户端每轮主要传递当前观测,长期历史由后台统一管理,从而支持连续交互与缓存复用。
运行时稳健性 系统设置超时、重连与取消机制,并通过会话级锁限制请求积压。必要时丢弃过期帧,避免模型持续处理滞后的画面;迟到的结果则按推理序号回填到对应历史位置。记忆整理并行执行,以减少对实时循环的阻塞。
四、实验结果与分析
评估设置
报告采用真实视频交互案例进行人类评估,对比对象为豆包与 Gemini 应用内视频通话功能。比较 JoyAI-VL-Interaction 系统在相同视频和提问条件下的交互表现。
正式评估包含六类场景、共58个案例:监控告警、实时计数、实时翻译、时间感知,以及直播解说与引导、长时视觉记忆。评估同时考虑回答质量与回答时机 :既看内容是否正确、相关,也看回答是否过早、过晚,以及不需要回应时是否保持沉默。两项评分等权汇总后,分别统计 JoyAI-VL-Interaction 相对于每个对照产品的胜、平、负比例。
人类偏好结果


相较豆包,JoyAI-VL-Interaction 的胜率为77.6% ,平局率为17.2%,负率为5.2%;相较 Gemini,其胜率为87.9% ,平局率为10.3%,负率为1.7%。这些数字表示特定案例中综合质量与时机后的偏好比例,不是通用视频理解准确率,也不是事件检测准确率。
分场景结果进一步体现了响应时机的作用。在监控告警场景中,JoyAI-VL-Interaction 对两个对照系统均取得100%的偏好胜率;实时翻译和计数中也没有出现落败案例。另一方面,在与豆包的直播解说与引导对比中,JoyAI-VL-Interaction 的胜率为55.6%,平局和负率均为22.2%,说明开放式解说仍受到知识、表达风格及内容质量等因素的影响。
典型案例与泛化表现
论文还展示了购物 App 引导和幻灯片讲解。作者指出,训练数据未直接覆盖相应的 App 界面视频或幻灯片授课任务,但模型仍能随屏幕变化继续引导,或按要求的节奏组织讲解。这些案例表明时间对齐训练可能支持交互能力在不同场景间组合与迁移,覆盖范围仍需更多系统性实验验证。相关案例展示可在项目主页查看。
局限性
本次评估突出的是需要持续感知与时机判断的任务。它支持“专门训练交互能力能够改善这类任务表现”的结论,但不能据此认定8B模型在通用知识、复杂推理和开放式对话中全面优于对照产品。
论文也指出了当前阶段的不足:模型规模较小,通用能力与复杂输入下的稳健性仍有提升空间;交互数据的规模、清洗质量和混合比例尚未充分优化,直播解说中偶尔出现幻觉;评估仅覆盖六类场景和58个案例,仍需要更广泛、更细粒度的验证。
五、总结
JoyAI-VL-Interaction 将视觉语言模型的训练目标扩展到连续交互:模型需要理解画面、维持用户意图,并自主决定何时回应、何时沉默、何时向后台求助。通过构造时间对齐数据,采用加权监督微调与强化学习,训练模型自主判断何时回应、保持沉默或委派任务。在此基础上,结合 AdaCodec 预测式视频编码、实时与异步双循环架构、分层记忆及前缀缓存复用,构建了支持长时间视频输入、主动响应与后台任务协作的实时视觉语言交互系统 JoyAI-VL-Interaction。在报告覆盖的事件驱动场景中取得了较高的人类偏好胜率。
这是首个同时开放模型权重、交互数据、训练方案及完整可部署系统的视觉驱动交互模型,为持续感知与自主响应的人机交互提供了可复现的技术方案。其研究价值在于说明,除了增加知识和推理能力,对交互时机与持续任务执行的专门训练,能显著影响助手的实际使用体验 。随着数据质量、模型能力和评估范围进一步完善,这一方向有望支持更自然的实时视频交互。
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


