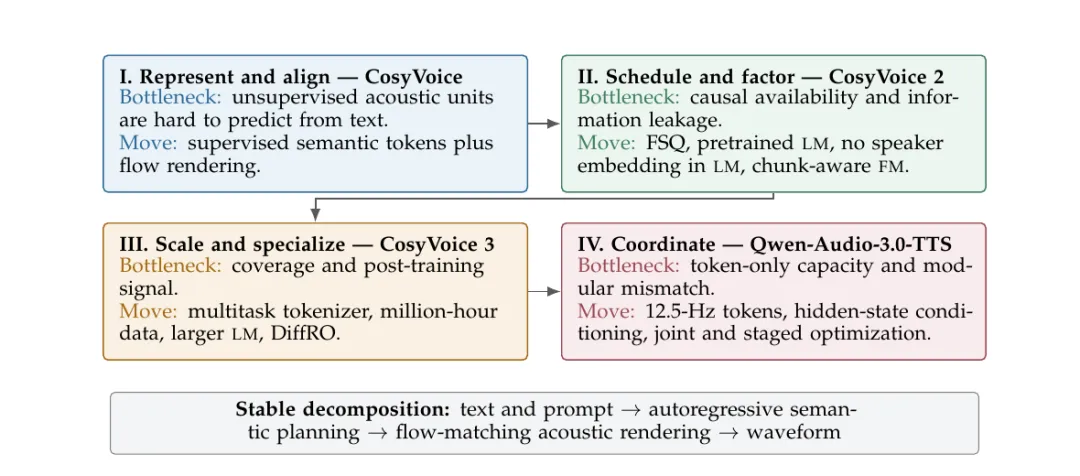
从 CosyVoice、CosyVoice 2、CosyVoice 3,到 Qwen-Audio-3.0-TTS,我们重新回看了四代语音生成系统的技术演进。
贯穿其中的主线并不是简单的“更多数据、更大模型、更强 tokenizer”,而是同一套系统框架先后解决了四类问题:表征、流式与分工、规模与后训练、接口容量与跨模块协同。

一个稳定框架:紧凑规划,连续渲染
四代系统都沿用同一条主干:
文本与提示 → 自回归语言模型(LM)完成语义规划 → 流匹配模型(FM)渲染连续声学细节 → 波形LM 不必串行描述所有声音细节,只需生成紧凑的语音计划;FM 则负责音色、韵律和声学细节。
真正不断演进的,是 LM 与 FM 之间的接口:传递什么信息、条件由谁负责、信息何时可用,以及哪些训练信号能够跨过边界。
第一题:如何让语音单元更容易从文本预测?
CosyVoice:从声学压缩转向有监督语义
传统神经 codec 主要为波形重建服务,其编码包含大量与文本弱相关的声学变化。若让自回归 LM 直接预测这些编码,内容规划就会与复杂声学细节耦合。
CosyVoice 将向量量化引入多语种 ASR 编码器,在有监督识别目标下学习包含 4,096 个条目的语义码本,使离散单元更贴近语言内容;FM 则承担连续声学重建。
这一代解决的是表征问题:先让语音计划具备明确的内容属性,并且能够稳定地由文本预测。
第二题:有了语义 token,如何真正支持流式生成?
CosyVoice 2:提高码本利用率,重新划分模块职责
CosyVoice 2 以有限标量量化(FSQ)替代 VQ。论文中的 tokenizer 评测显示,6,561 码空间达到完整利用,而 4,096 条目的 VQ 基线利用率为 23%。
系统同时从 LM 中移除句级说话人嵌入,把显式音色条件保留在 FM;双流调度与 chunk-aware 因果 FM,则让语义规划与声学生成能够在兼容的时间边界上协同。
关键不是删除说话人信息,而是把条件交给真正消费它的模块。这一代解决了两个相互关联的问题:信息能否及时到达,以及内容与音色应该分别由谁负责。
第三题:规模扩大后,如何继续优化难例和真实场景?
CosyVoice 3:从规模化走向可奖励优化
CosyVoice 3 将生成训练数据扩展到 100 万小时,覆盖 9 种语言及广泛的中文方言变化;多任务语音编码器从 53 万小时数据中学习 25 Hz FSQ token。LM 从 0.5B 扩展到 1.5B,FM 从 100M 扩展到 300M。
规模扩大之外,tokenizer 进一步融合 ASR、语言识别、情感识别、音频事件检测和说话人分析等监督。DiffRO 则通过 token 域奖励,让纠正性梯度直接到达 LM,使语音计划不仅可预测,也能够被更有针对性地优化。
在流式链路上,CosyVoice 3 还将 HiFT 声码器改造成因果形式,以连续因果生成取代依赖淡入淡出的波形拼接,避免由此带来的边界模糊。
这一代解决的是可学习性与覆盖问题:扩大系统能力的同时,让残余错误获得更直接的优化信号。
第四题:降低 token 帧率后,如何避免接口容量不足?
Qwen-Audio-3.0-TTS:保留离散支架,放松 token-only 瓶颈
生产延迟希望减少自回归步数,而可控性、长文本、说话人保真和鲁棒性又需要足够丰富的信息。
Qwen-Audio-3.0-TTS 将 tokenizer 帧率从 25 Hz 降至 12.5 Hz,同时把 FSQ 空间扩展到最多 3¹⁰ = 59,049 个可能索引。论文内部对比表明:只降低帧率会带来损失,提高单步容量可以恢复大部分性能。
更重要的是,系统仍保留离散 token 作为语义预测目标,却不再让 token embedding 成为 FM 的唯一直接条件。连续 LM 隐状态取代它成为渲染接口,既能携带更丰富的信息,也允许 flow loss 在联合训练时反向塑造上游表征。
模块没有消失,边界被“软化”了。

为了避免端到端训练过早破坏模块能力,Qwen-Audio-3.0-TTS 采用五阶段渐进训练:独立预训练 → 联合训练与质量退火 → LM 强化学习 → FM 鲁棒性训练 → FM 强化学习。
这套顺序的核心是:先让模块各自具备能力,再解决接口失配;先优化语义规划,再处理声学鲁棒性和最终感知质量。
一张统一的“解题地图”
我们把 LM 与 FM 之间的接口契约写成:
𝓘 = (R, O, A, G)- R · Representation:跨过边界的表征是什么?
- O · Ownership:内容、音色等因素由谁负责?
- A · Availability:接口信息何时可以用于推理?
- G · Gradient reach:哪些目标能够跨越边界塑造上游?

这四个问题提供了一种比“比较版本号”更有用的诊断方式:内容错误更可能指向表征与规划;退化参考音频导致音色漂移,更可能指向声学条件;质量不变但延迟过高,则应首先检查 token 帧率和可用时序。
结语
回看四代系统,真正稳定的不是某一种 tokenizer、某一个模型规模或某一套训练算法,而是紧凑语义规划与连续声学渲染之间的功能分解。
CosyVoice 对齐表征,CosyVoice 2 解决流式与分工,CosyVoice 3 扩大覆盖并引入后训练,Qwen-Audio-3.0-TTS 则进一步拓宽接口容量、协调跨模块优化。
下一代模块化语音生成器,仍然需要持续回答四个问题:什么信息跨过边界?由谁负责?何时可用?又有哪些梯度能够到达这里?
需要说明的是,本文是一篇技术回顾,而不是跨四代系统的合成排行榜。不同论文使用的数据、checkpoint 和评测栈并不完全一致;文中的“瓶颈迁移”是由论文内部消融与明确架构变化约束的机制性解释,而不是受控的跨版本因果实验。
高保真零样本语音合成也伴随冒充、欺诈及未经授权的声音克隆等风险。真实部署需要结合知情授权、来源标记或有效水印、访问控制、滥用监测及合成媒体披露机制。
相关文献参考:
[1] Du, Z. et al. CosyVoice: A Scalable Multilingual Zero-shot Text-to-speech Synthesizer Based on Supervised Semantic Tokens. arXiv:2407.05407, 2024.
[2] Du, Z. et al. CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models. arXiv:2412.10117, 2024.
[3] Du, Z. et al. CosyVoice 3: Towards In-the-wild Speech Generation via Scaling-up and Post-training. arXiv:2505.17589, 2025.
[4] Xiang, B. et al. Qwen-Audio-3.0-TTS: Freely Controllable and Highly Robust Speech Synthesis with Multi-Stage Training Paradigm. arXiv:2607.23938, 2026.
[5] Wang, C. et al. Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers. arXiv:2301.02111, 2023.
[6] Le, M. et al. Voicebox: Text-Guided Multilingual Universal Speech Generation at Scale. NeurIPS, 2023.
[7] Chen, Y. et al. F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching. arXiv:2410.06885, 2024.
[8] Lipman, Y. et al. Flow Matching for Generative Modeling. ICLR, 2023.
[9] Mentzer, F. et al. Finite Scalar Quantization: VQ-VAE Made Simple. ICLR, 2024.
[10] Yu, F. et al. JoyVoice: Long-Context Conditioning for Anthropomorphic Multi-Speaker Conversational Synthesis. arXiv:2512.19090, 2025.
版权声明:本文内容转自互联网,本文观点仅代表作者本人。本站仅提供信息存储空间服务,所有权归原作者所有。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至1393616908@qq.com 举报,一经查实,本站将立刻删除。


