作者:Zimu Guan
原文链接:https://www.qualcomm.com/developer/blog/2026/10/how-to-share-vulkan-opencl-workloads-android-adreno-gpus
Android GPU 管线可能使用 Vulkan 进行渲染,同时依靠现有的 OpenCL 内核完成计算、机器学习、降噪或超分辨率处理。通过 CPU 中转中间结果,会带来不必要的复制和同步开销。本教程介绍如何在搭载 Adreno GPU 的 Android 设备上,让 Vulkan 与 OpenCL 直接共享 GPU 内存并协调工作负载,包括实现完整的 Vulkan → OpenCL → Vulkan 工作流所需的外部内存句柄、所有权转移和 sync FD 信号量。
你将构建的内容:一条 Vulkan → OpenCL → Vulkan 管线,直接共享 GPU 内存,在共享资源上运行 OpenCL 内核,再将结果交回 Vulkan,无需通过 CPU 中转。
团队提示:本文介绍的配置及功能支持情况,通常适用于采用目标 Android 驱动栈的Snapdragon 8 Elite Gen 5处理器及后续产品。为确保表述准确,本文假定设备支持所需能力。实际支持情况仍取决于设备和驱动,因此应用应以运行时能力查询结果为准。
Adreno GPU 在 Android 上的互操作扩展
Vulkan/OpenCL 互操作涉及多个扩展和句柄类型。内存共享与同步采用不同的外部对象机制。对于 Android 上的 Adreno GPU,可采用以下机制:
| 用途 | Vulkan 端 | OpenCL 端 |
|---|---|---|
| 查询外部对象支持情况 | VK_KHR_external_memory_capabilities[2]、VK_KHR_external_semaphore_capabilities | OpenCL 平台或设备扩展查询 |
| 匹配设备与驱动 | VkPhysicalDeviceIDProperties::{deviceUUID, driverUUID}[3] | cl_khr_device_uuid[4]、CL_DEVICE_UUID_KHR、CL_DRIVER_UUID_KHR |
| 跨 API 内存共享 | VK_KHR_external_memory[5] 及特定句柄对应的扩展(见下文) | cl_khr_external_memory[6] 及特定句柄对应的扩展(见下文) |
| 跨 API 同步 | VK_KHR_external_semaphore[7]、VK_KHR_external_semaphore_fd、VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT | cl_khr_external_semaphore[8]、cl_khr_external_semaphore_sync_fd、CL_SEMAPHORE_HANDLE_SYNC_FD_KHR |
跨 API 内存共享有多种可选方案,因此这里的情况稍显复杂,具体如下表所示。
| 跨 API 内存共享方案 | Vulkan 端 | OpenCL 端 | 典型用途与限制 |
|---|---|---|---|
| 通用 opaque fd | VK_KHR_external_memory_fd[9]、VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR | cl_khr_external_memory_opaque_fd[10]、CL_EXTERNAL_MEMORY_HANDLE_OPAQUE_FD_KHR | 用于缓冲区和线性平铺图像。对于最优平铺图像,无法可靠推断其平铺布局。 |
| 高通 Vulkan opaque fd | 与通用 opaque fd 相同的 Vulkan 扩展和句柄类型 | cl_qcom_external_memory_vulkan_opaque_fd[11]、CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM | 用于 Vulkan 图像,可推断格式和内部内存布局。高通专有。 |
| Android Hardware Buffer | VK_ANDROID_external_memory_android_hardware_buffer[12]、VK_EXTERNAL_MEMORY_HANDLE_TYPE_ANDROID_HARDWARE_BUFFER_BIT_ANDROID | cl_khr_external_memory_android_hardware_buffer[13] | Android 原生共享机制,可推断格式、尺寸和数据布局。 |
| DMA-BUF | VK_KHR_external_memory_fd[9]、VK_EXT_external_memory_dma_buf、VK_EXTERNAL_MEMORY_HANDLE_TYPE_DMA_BUF_BIT_EXT | cl_khr_external_memory_dma_buf[14] | 用于现有的底层 Linux 分配器、媒体及显示管线。图像格式和布局需要另行约定。 |
共享缓冲区和线性平铺图像时,通用 opaque fd 通常已经足够。最优平铺图像则更为棘手,因为其平铺布局由实现定义,而仅凭 fd 无法描述这种布局。
Android Hardware Buffer 以 Android 原生方式解决这一问题,并得到多家厂商的支持。高通技术公司也提供了 Vulkan opaque fd 扩展,可补充 Vulkan 图像所需的信息。只需修改几行代码,就能轻松将该扩展集成到现有的 opaque fd 实现中。
DMA-BUF 所处的层次更底层。相比应用层的 Vulkan/OpenCL 互操作,它更常见于系统、媒体、相机和显示管线。
本文其余部分将重点介绍通用 opaque fd 方案和高通技术公司的 Vulkan opaque fd 方案。我们将在后续文章中介绍基于 AHB 的 Vulkan/OpenCL 互操作,敬请关注。
在使用基于 opaque fd 的共享内存对象之前,还需完成一项配置检查:Vulkan 与 OpenCL 必须指向同一个物理 GPU,并使用兼容的驱动。为此,需要分别将 VkPhysicalDeviceIDProperties::deviceUUID 和 VkPhysicalDeviceIDProperties::driverUUID,与 cl_khr_device_uuid 提供的 CL_DEVICE_UUID_KHR 和 CL_DRIVER_UUID_KHR 进行比较。
仅匹配设备 UUID 可以确认是同一个 GPU,但不足以保证 opaque fd 兼容性。这里不展开介绍这部分匹配代码。
API 之间的内存共享
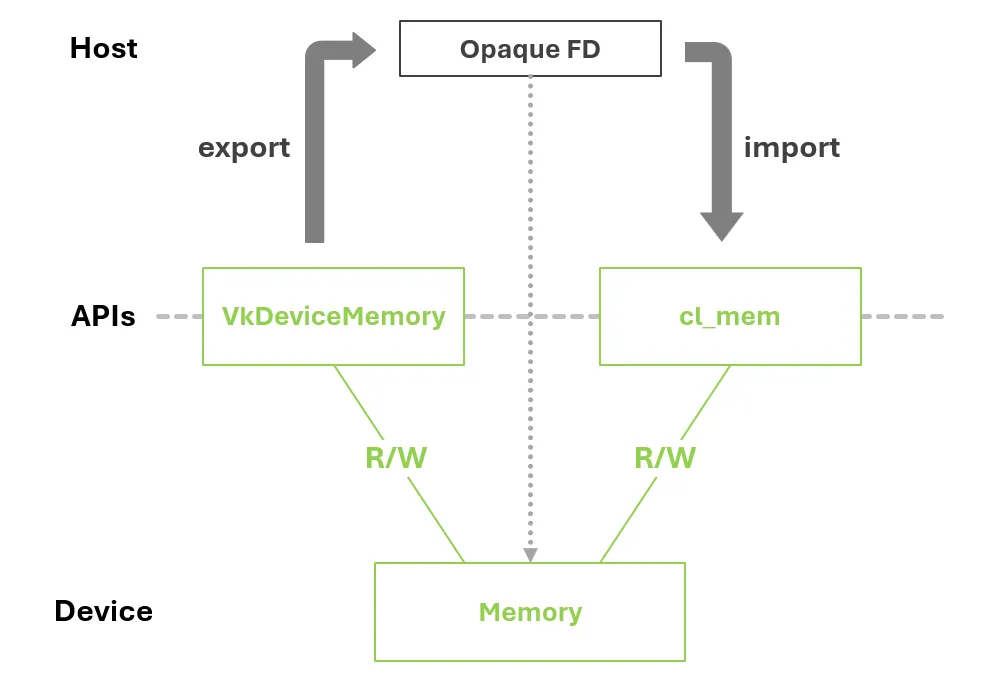

内存共享使 Vulkan 与 OpenCL 各自拥有独立的 API 对象,而这些对象指向同一块分配的 GPU 内存。在本文的 opaque fd 内存共享流程中,Vulkan 将分配的内存以 VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR 类型导出。随后,OpenCL 可根据资源类型,使用通用 opaque fd 句柄或高通技术公司的 Vulkan opaque fd 句柄导入该 fd:
| 通过 opaque fd 导入的 Vulkan 资源 | CL_EXTERNAL_MEMORY_HANDLE_OPAQUE_FD_KHR | CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM |
|---|---|---|
| 缓冲区 | 可用 | 可用,对缓冲区的行为与通用句柄相同 |
| 线性平铺 Vulkan 图像 | 可用 | 可用,可推断图像格式和布局 |
| 最优平铺 Vulkan 图像 | 通常不适用于 Android 上的 Adreno GPU | 必须使用 |
CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM 句柄并非仅用于最优平铺图像。对于缓冲区,其行为与通用 opaque fd 句柄相同;对于图像,它允许实现推断 Vulkan 图像的格式和内部布局。
导入最优平铺 Vulkan 图像时,这一区别非常关键。在 Adreno 上,CL_EXTERNAL_MEMORY_HANDLE_OPAQUE_FD_KHR 通常会列在 CL_DEVICE_EXTERNAL_MEMORY_IMPORT_ASSUME_LINEAR_IMAGES_HANDLE_TYPES_KHR 中,因此 OpenCL 会将通过该句柄导入的图像视为线性平铺图像。若将它用于最优平铺 Vulkan 图像,Vulkan 与 OpenCL 可能会以不同方式解释同一块分配的内存,从而导致未定义行为。CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM 允许 OpenCL 推断 Vulkan 图像的格式和内部布局,因此可避免这种不匹配。
关于 cl_qcom_external_memory_vulkan_opaque_fd 的声明和完整规范,请参阅高通 OpenCL SDK。
下面来看如何在实际应用中配置和使用内存共享。
初始化通用 opaque fd 导入
我们先从通用 opaque fd 句柄 CL_EXTERNAL_MEMORY_HANDLE_OPAQUE_FD_KHR 开始。在 Adreno 上,它可用于缓冲区和线性平铺图像。
配置分为四个步骤:
1. 创建启用外部内存的 Vulkan 资源。
2. 分配可导出的 Vulkan 内存,并将其绑定到资源。
3. 从 Vulkan 导出内存 fd。
4. 将 fd 导入 OpenCL,并创建 cl_mem。
创建可导出的 Vulkan 资源
对于缓冲区,将 VkExternalMemoryBufferCreateInfo 添加到 VkBufferCreateInfo::pNext 链中:
VkExternalMemoryBufferCreateInfo external_buffer_info = {};
external_buffer_info.sType = VK_STRUCTURE_TYPE_EXTERNAL_MEMORY_BUFFER_CREATE_INFO;
external_buffer_info.handleTypes = VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR;

VkBufferCreateInfo buffer_info = {};
buffer_info.sType = VK_STRUCTURE_TYPE_BUFFER_CREATE_INFO;
buffer_info.pNext = &external_buffer_info;
buffer_info.size = size;
buffer_info.usage = usage;

vkCreateBuffer(device, &buffer_info, nullptr, &buffer);
对于图像,使用 VkExternalMemoryImageCreateInfo:
VkExternalMemoryImageCreateInfo external_image_info = {};
external_image_info.sType = VK_STRUCTURE_TYPE_EXTERNAL_MEMORY_IMAGE_CREATE_INFO;
external_image_info.handleTypes = VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR;

VkImageCreateInfo image_info = {};
image_info.sType = VK_STRUCTURE_TYPE_IMAGE_CREATE_INFO;
image_info.pNext = &external_image_info;
image_info.imageType = VK_IMAGE_TYPE_2D;
image_info.format = VK_FORMAT_R8G8B8A8_UNORM;
image_info.extent = {width, height, 1};
image_info.mipLevels = 1;
image_info.arrayLayers = 1;
image_info.samples = VK_SAMPLE_COUNT_1_BIT;
image_info.tiling = VK_IMAGE_TILING_LINEAR;
image_info.usage = usage;

vkCreateImage(device, &image_info, nullptr, &image);
这种通用导入方式适用于线性平铺图像。最优平铺图像将在后文介绍。
分配可导出的内存
仅创建资源还不够,绑定到该资源的内存也必须可导出:
VkExportMemoryAllocateInfoKHR export_info = {};
export_info.sType = VK_STRUCTURE_TYPE_EXPORT_MEMORY_ALLOCATE_INFO_KHR;
export_info.handleTypes = VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR;

VkMemoryAllocateInfo alloc_info = {};
alloc_info.sType = VK_STRUCTURE_TYPE_MEMORY_ALLOCATE_INFO;
alloc_info.pNext = &export_info;
alloc_info.allocationSize = memory_requirements.size;
alloc_info.memoryTypeIndex = memory_type_index;
某些外部缓冲区和图像还可能需要专用分配。要确认这一点,可查询 opaque fd 句柄类型的外部内存属性,并检查 externalMemoryFeatures。对于缓冲区,使用 vkGetPhysicalDeviceExternalBufferProperties。对于图像,使用 vkGetPhysicalDeviceImageFormatProperties2,在输入链中加入 VkPhysicalDeviceExternalImageFormatInfo,在输出链中加入 VkExternalImageFormatProperties。
如果 externalMemoryFeatures 包含 VK_EXTERNAL_MEMORY_FEATURE_DEDICATED_ONLY_BIT,则将 VkMemoryDedicatedAllocateInfo 添加到分配链中:
VkMemoryDedicatedAllocateInfo dedicated_info = {};

// external_memory_features is returned by the corresponding buffer or image capability query.
if ((external_memory_features &
     VK_EXTERNAL_MEMORY_FEATURE_DEDICATED_ONLY_BIT) != 0) {
    dedicated_info.sType = VK_STRUCTURE_TYPE_MEMORY_DEDICATED_ALLOCATE_INFO;
    dedicated_info.image = image; // for image allocation
    dedicated_info.buffer = VK_NULL_HANDLE;

    // for buffer allocation:
    // dedicated_info.image = VK_NULL_HANDLE;
    // dedicated_info.buffer = buffer;

    export_info.pNext = &dedicated_info;
}
然后分配并绑定内存:
vkAllocateMemory(device, &alloc_info, nullptr, &memory);
// for image
vkBindImageMemory(device, image, memory, 0);
// for buffer
// vkBindBufferMemory(device, buffer, memory, 0);
从 Vulkan 导出 fd
分配内存后,从 VkDeviceMemory 导出一个 POSIX fd:
int fd = -1;

VkMemoryGetFdInfoKHR fd_info = {};
fd_info.sType = VK_STRUCTURE_TYPE_MEMORY_GET_FD_INFO_KHR;
fd_info.handleType = VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR;
fd_info.memory = memory;

vkGetMemoryFdKHR(device, &fd_info, &fd);
该 fd 指向从 Vulkan 导出的那块内存,现在可以将其导入 OpenCL。
将 fd 导入 OpenCL
OpenCL 在创建内存对象时,使用以下属性列表导入此前导出的 fd:
cl_mem_properties props[] = {
    CL_EXTERNAL_MEMORY_HANDLE_OPAQUE_FD_KHR,
    (cl_mem_properties)fd,
    CL_MEM_DEVICE_HANDLE_LIST_KHR,
    (cl_mem_properties)cl_device,
    CL_MEM_DEVICE_HANDLE_LIST_END_KHR,
    0
};
对于缓冲区,创建一个 cl_mem 缓冲区:
cl_int err = CL_SUCCESS;
cl_mem cl_buffer = clCreateBufferWithProperties(
    /*context*/      context,
    /*properties*/   props,
    /*flags*/        flags,
    /*size*/         size,
    /*host_ptr*/     nullptr,
    /*errcode_ret*/  &err);
对于线性平铺图像,在创建 cl_mem 图像之前,先查询 Vulkan 子资源布局,再将其中的 rowPitch 传给 OpenCL。对于外部内存图像,如果将 image_row_pitch 保持为零,其行间距就由实现定义,可能与 Vulkan 的填充方式不一致。
// query the Vulkan subresource layout
VkImageSubresource subresource = {};
subresource.aspectMask = VK_IMAGE_ASPECT_COLOR_BIT;
subresource.mipLevel = 0;
subresource.arrayLayer = 0;

VkSubresourceLayout vulkan_layout = {};
vkGetImageSubresourceLayout(device, image, &subresource, &vulkan_layout);

// create OpenCL image
cl_image_format format = {};
format.image_channel_order = CL_RGBA;
format.image_channel_data_type = CL_UNORM_INT8;

cl_image_desc desc = {};
desc.image_type        = CL_MEM_OBJECT_IMAGE2D;
desc.image_width       = width;
desc.image_height      = height;
desc.image_depth       = 0; // only used for 3D image.
desc.image_array_size  = 0; // only used for 1D/2D image array

// If image_row_pitch is zero and the image is created from an external
// memory handle, then the image row pitch is implementation-defined.
// Vulkan may pad each row. Using zero here would let OpenCL choose an
// implementation-defined pitch that may not match Vulkan's rowPitch.
desc.image_row_pitch   = (size_t)vulkan_layout.rowPitch;

// Not used for a non-array 2D image. For an image array, use the queried
// arrayPitch; for a 3D image, use depthPitch.
desc.image_slice_pitch = 0;

desc.num_mip_levels    = 0; // must be 0 unless cl_khr_mipmap_image is supported
desc.num_samples       = 0; // must be 0
desc.buffer            = nullptr;

cl_mem cl_image = clCreateImageWithProperties(
    /*context*/      context,
    /*properties*/   props,
    /*flags*/        flags,
    /*image_format*/ &format,
    /*image_desc*/   &desc,
    /*host_ptr*/     nullptr,
    /*errcode_ret*/  &err);
这里的通用 opaque fd 句柄仅适用于线性平铺 Vulkan 图像。对于最优平铺图像,仍采用相同的 Vulkan 内存导出流程,但在 OpenCL 端使用高通技术公司的 Vulkan opaque fd 导入句柄。
初始化高通技术公司的 Vulkan opaque fd 导入
cl_qcom_external_memory_vulkan_opaque_fd 扩展新增了 CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM。这是一种 OpenCL 导入句柄,用于导入由高通 Vulkan 驱动导出的 Vulkan 内存分配。该扩展的适用范围更广,但本文使用它的原因是需要导入最优平铺图像。
这一流程与通用 opaque fd 导入几乎相同:创建外部 Vulkan 资源,分配可导出的内存,导出 fd,再根据该 fd 创建 cl_mem。我们先从 Vulkan 端开始,这一端的外部内存设置保持不变,图像本身则以最优平铺方式创建。
创建 Vulkan 图像
将 Vulkan 图像创建为支持外部内存的最优平铺图像:
VkExternalMemoryImageCreateInfo external_image_info = {};
external_image_info.sType = VK_STRUCTURE_TYPE_EXTERNAL_MEMORY_IMAGE_CREATE_INFO;
external_image_info.handleTypes = VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR;

VkImageCreateInfo image_info = {};
image_info.sType = VK_STRUCTURE_TYPE_IMAGE_CREATE_INFO;
image_info.pNext = &external_image_info;
image_info.imageType = VK_IMAGE_TYPE_2D;
image_info.format = VK_FORMAT_R8G8B8A8_UNORM;
image_info.extent = {width, height, 1};
image_info.mipLevels = 1;
image_info.arrayLayers = 1;
image_info.samples = VK_SAMPLE_COUNT_1_BIT;
image_info.tiling = VK_IMAGE_TILING_OPTIMAL; // Different: optimal tiling.
image_info.usage = usage;

vkCreateImage(device, &image_info, nullptr, &image);
然后按照前面的方式分配可导出的内存,将其绑定到图像,并导出 fd。获得该 fd 后,高通技术公司特有的处理发生在 OpenCL 导入阶段。
使用高通扩展导入
与通用的线性平铺图像导入相比,OpenCL 对象的创建方式几乎相同。两个关键区别在于句柄类型,以及 image_format 为空:
cl_mem_properties props[] = {
    // Different: use the Qualcomm Vulkan opaque-fd handle on the OpenCL side.
    CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM,
    (cl_mem_properties)fd,
    CL_MEM_DEVICE_HANDLE_LIST_KHR,
    (cl_mem_properties)cl_device,
    CL_MEM_DEVICE_HANDLE_LIST_END_KHR,
    0
};

cl_image_desc desc = {};
desc.image_type        = CL_MEM_OBJECT_IMAGE2D;
desc.image_width       = width;
desc.image_height      = height;
desc.image_depth       = 0;
desc.image_array_size  = 0;
desc.image_row_pitch   = 0; // must be zero
desc.image_slice_pitch = 0; // must be zero
desc.num_mip_levels    = 0;
desc.num_samples       = 0;
desc.buffer            = nullptr;

cl_mem cl_image = clCreateImageWithProperties(
    /*context*/      context,
    /*properties*/   props,
    /*flags*/        flags,
    /*image_format*/ nullptr, // Different: must be nullptr, image format is inferred from the Vulkan image.
    /*image_desc*/   &desc,
    /*host_ptr*/     nullptr,
    /*errcode_ret*/  &err);
使用 cl_qcom_external_memory_vulkan_opaque_fd 时,还需要注意以下几项图像专用规则:
• cl_image_desc 必须与 Vulkan 图像匹配。
• 行间距(row pitch)和切片间距(slice pitch)必须为零。
• 图像类型必须为 CL_MEM_OBJECT_IMAGE2D、CL_MEM_OBJECT_IMAGE2D_ARRAY 或 CL_MEM_OBJECT_IMAGE3D。
• Vulkan/OpenCL 格式配对必须列在该扩展规范中。导入未列出的格式可能导致未定义行为。
• 不支持部分驻留的 Vulkan 图像。
完整细节请参阅 高通 OpenCL SDK[11] 中包含的 cl_qcom_external_memory_vulkan_opaque_fd 规范。
渲染循环中的外部内存获取与释放
在每一帧中,都必须在 Vulkan 与 OpenCL 之间显式转移共享内存的访问权。Vulkan 使用队列族所有权屏障,将共享资源释放给 VK_QUEUE_FAMILY_EXTERNAL,并在之后重新获取;OpenCL 则使用 clEnqueueAcquireExternalMemObjectsKHR 和 clEnqueueReleaseExternalMemObjectsKHR。
在 Vulkan 的生产者工作之后,将图像释放给 VK_QUEUE_FAMILY_EXTERNAL:
// record Vulkan work that produces the shared resource
// record a barrier that releases ownership of the shared resource to the external queue family
VkImageMemoryBarrier release_to_opencl{};
release_to_opencl.sType               = VK_STRUCTURE_TYPE_IMAGE_MEMORY_BARRIER;
release_to_opencl.srcAccessMask       = access_mask_before_release;
release_to_opencl.dstAccessMask       = 0;
release_to_opencl.oldLayout           = image_layout_before_release;
release_to_opencl.newLayout           = VK_IMAGE_LAYOUT_GENERAL;
release_to_opencl.srcQueueFamilyIndex = vulkan_queue_family_index;
release_to_opencl.dstQueueFamilyIndex = VK_QUEUE_FAMILY_EXTERNAL;
release_to_opencl.image               = shared_image;
release_to_opencl.subresourceRange    = {VK_IMAGE_ASPECT_COLOR_BIT, 0, 1, 0, 1};

vkCmdPipelineBarrier(cmd, stage_mask_before_release, VK_PIPELINE_STAGE_BOTTOM_OF_PIPE_BIT,
                     0, 0, nullptr, 0, nullptr, 1, &release_to_opencl);

// submit the command buffer with proper cross-API synchronization
在该屏障之后进行适当的跨 API 同步,OpenCL 就可以获取已导入的对象,使用它们,再将其释放:
// assume an in-order OpenCL command queue
cl_mem objects[] = {cl_input, cl_output};
cl_uint num_objects = 2;

clEnqueueAcquireExternalMemObjectsKHR(
    /*command_queue*/           queue,
    /*num_mem_objects*/         num_objects,
    /*mem_objects*/             objects,
    /*num_events_in_wait_list*/ 0,
    /*event_wait_list*/         nullptr,
    /*event*/                   nullptr);

clEnqueueNDRangeKernel(...);

clEnqueueReleaseExternalMemObjectsKHR(
    /*command_queue*/           queue,
    /*num_mem_objects*/         num_objects,
    /*mem_objects*/             objects,
    /*num_events_in_wait_list*/ 0,
    /*event_wait_list*/         nullptr,
    /*event*/                   nullptr);
OpenCL 工作和内存释放操作与 Vulkan 完成适当同步后,Vulkan 就可以重新获取所有权:
// record a barrier that acquires ownership of the shared image from the external queue family
VkImageMemoryBarrier acquire_from_opencl{};
acquire_from_opencl.sType               = VK_STRUCTURE_TYPE_IMAGE_MEMORY_BARRIER;
acquire_from_opencl.srcAccessMask       = 0;
acquire_from_opencl.dstAccessMask       = access_mask_after_acquire;
acquire_from_opencl.oldLayout           = VK_IMAGE_LAYOUT_GENERAL;
acquire_from_opencl.newLayout           = image_layout_after_acquire;
acquire_from_opencl.srcQueueFamilyIndex = VK_QUEUE_FAMILY_EXTERNAL;
acquire_from_opencl.dstQueueFamilyIndex = vulkan_queue_family_index;
acquire_from_opencl.image               = shared_image;
acquire_from_opencl.subresourceRange    = {VK_IMAGE_ASPECT_COLOR_BIT, 0, 1, 0, 1};

vkCmdPipelineBarrier(cmd, VK_PIPELINE_STAGE_TOP_OF_PIPE_BIT, stage_mask_after_acquire,
                     0, 0, nullptr, 0, nullptr, 1, &acquire_from_opencl);

// record Vulkan work that consumes the shared resource
// submit the command buffer with proper cross-API synchronization
共享缓冲区使用 VkBufferMemoryBarrier,遵循相同的所有权转移顺序。以相同方向设置 Vulkan 队列族和 VK_QUEUE_FAMILY_EXTERNAL,并将 offset 和 size 设置为共享缓冲区的范围。
Vulkan 所有权屏障与 OpenCL 获取和释放命令,使接收方 API 能够访问共享资源。它们本身并不确定 Vulkan 工作与 OpenCL 工作之间的执行先后顺序。外部信号量负责提供这种跨 API 的执行顺序。
API 之间的同步
同步是互操作的另一半。两个 API 都能够引用同一块内存之后,我们仍然需要安排 GPU 工作的执行顺序,确保任何一方都不会读取过期数据,也不会在另一方仍使用资源时进行写入。

不同 GPU 实现可能提供不同的互操作信号量句柄类型。基于信号量 opaque fd 句柄的工作流程,例如 Khronos OpenCL 互操作示例[15]中的 Unix 实现,并不等同于 Android 上使用的 sync fd 方式。句柄类型会改变信号量载荷的生命周期与所有权模型。
| 信号量句柄类型 | fd 表示的内容 | 生命周期模型 | Android 支持情况 |
|---|---|---|---|
| VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_OPAQUE_FD_BIT, CL_SEMAPHORE_HANDLE_OPAQUE_FD_KHR | 指向两个 API 对象共享的信号量载荷或状态的句柄 | 初始化后持续关联 | 不支持 |
| VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT, CL_SEMAPHORE_HANDLE_SYNC_FD_KHR | 用于单个同步点的 Linux sync-file / Android fence 载荷 | 一次性;下一个同步点需要重新导出和导入 | 支持 |
使用信号量 opaque fd 句柄时,fd 是指向底层信号量载荷的句柄。一个 API 将其导出、另一个 API 将其导入后,Vulkan 信号量与 OpenCL 信号量就会引用同一个信号状态。这种关联会持续存在:只需初始化一次共享信号量对象,随后即可在帧循环中使用它们。
sync fd 的情况有所不同。sync fd 是用于单个同步点的 Linux sync-file / Android fence。导入它并不会在 Vulkan 与 OpenCL 的信号量对象之间建立永久关联,而是将当前的等待/已发出信号状态作为临时载荷进行转移。一旦该载荷被导出,导出方就应将其视为已消耗。
因此,每次交接都需要导出和导入 sync fd 载荷。对于每一个从 Vulkan 到 OpenCL 或从 OpenCL 到 Vulkan 的同步点,都要导出一个新的 sync fd,将其导入另一 API 的信号量,然后在正常的队列工作中等待该信号量或向其发出信号。
了解这种一次性模型后,本文余下部分将以一帧 Vulkan → OpenCL → Vulkan 流程为例。这一流程需要两个方向的同步:从 Vulkan 到 OpenCL,以及从 OpenCL 返回 Vulkan。
初始化跨 API 信号量
我们为每个方向使用一对信号量。每一对都包含一个 Vulkan 端信号量对象和一个 OpenCL 端信号量对象,因此本例会创建两个 Vulkan 信号量和两个 OpenCL 信号量。
创建 Vulkan 信号量
创建将要导出给 OpenCL 的 Vulkan 信号量,并为其启用 sync fd 导出能力:
VkExportSemaphoreCreateInfo export_info = {};
export_info.sType = VK_STRUCTURE_TYPE_EXPORT_SEMAPHORE_CREATE_INFO;
export_info.handleTypes = VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT;

VkSemaphoreCreateInfo semaphore_info = {};
semaphore_info.sType = VK_STRUCTURE_TYPE_SEMAPHORE_CREATE_INFO;
semaphore_info.pNext = &export_info;

vkCreateSemaphore(device, &semaphore_info, nullptr, &vk_sema_vk_to_cl);
再创建一个 Vulkan 信号量,用于接收 OpenCL 发出的信号:
VkSemaphoreCreateInfo semaphore_info = {};
semaphore_info.sType = VK_STRUCTURE_TYPE_SEMAPHORE_CREATE_INFO;

vkCreateSemaphore(device, &semaphore_info, nullptr, &vk_sema_cl_to_vk);
创建 OpenCL 信号量
使用 -1 创建从 Vulkan 到 OpenCL 方向的信号量。-1 是一个特殊占位值,表示已经发出信号的 sync fd 载荷。导入会成功,信号量会收到一个临时载荷,就像提供了有效 fd 一样:
int init_fd = -1; // -1 fd is treated like a valid sync fd referring to an object that has already signaled

cl_semaphore_properties_khr import_props[] = {
    CL_SEMAPHORE_TYPE_KHR,
    CL_SEMAPHORE_TYPE_BINARY_KHR,
    CL_SEMAPHORE_HANDLE_SYNC_FD_KHR,
    (cl_semaphore_properties_khr)init_fd,
    CL_SEMAPHORE_DEVICE_HANDLE_LIST_KHR,
    (cl_semaphore_properties_khr)cl_device,
    CL_SEMAPHORE_DEVICE_HANDLE_LIST_END_KHR,
    0
};

cl_semaphore_khr cl_sema_vk_to_cl = clCreateSemaphoreWithPropertiesKHR(context, import_props, &err);
创建从 OpenCL 到 Vulkan 方向的信号量,并启用 sync fd 导出:
cl_semaphore_properties_khr export_props[] = {
    CL_SEMAPHORE_TYPE_KHR,
    CL_SEMAPHORE_TYPE_BINARY_KHR,
    CL_SEMAPHORE_EXPORT_HANDLE_TYPES_KHR,
    CL_SEMAPHORE_HANDLE_SYNC_FD_KHR,
    CL_SEMAPHORE_EXPORT_HANDLE_TYPES_LIST_END_KHR,
    CL_SEMAPHORE_DEVICE_HANDLE_LIST_KHR,
    (cl_semaphore_properties_khr)cl_device,
    CL_SEMAPHORE_DEVICE_HANDLE_LIST_END_KHR,
    0
};

cl_semaphore_khr cl_sema_cl_to_vk = clCreateSemaphoreWithPropertiesKHR(context, export_props, &err);
到这里,我们已经创建了可复用的信号量对象,但还没有交换有效的 sync fd。由于 sync fd 载荷是一次性的,每个跨 API 同步点所需的新 fd,都将在渲染循环中导出和导入,而不是在此处。
渲染循环中的导出 导入 等待与信号操作
现在从初始化阶段转到渲染循环。
初始化阶段创建的信号量对象会在各帧之间复用,但 sync fd 载荷是一次性的。每当工作从一个 API 转交给另一个 API 时,发出信号的一方都会导出一个新的 sync fd,等待的一方则在等待之前将其导入。
因此,我们的一帧 Vulkan → OpenCL → Vulkan 流程需要两次交接:
Vulkan -> OpenCL:
    Vulkan work signals a semaphore
    Vulkan exports a sync fd
    OpenCL re-imports the fd
    OpenCL work waits on the semaphore

OpenCL -> Vulkan:
    OpenCL work signals a semaphore
    OpenCL exports a sync fd
    Vulkan imports the fd
    Vulkan work waits on the semaphore
从 Vulkan 到 OpenCL
提交 Vulkan 工作时,安排向 Vulkan 到 OpenCL 方向的信号量发出信号,然后将该信号量载荷导出为 sync fd。此时,信号量可能已经发出信号,也可能仍有一个待执行的信号操作;这两种状态都可以导出。
// Submit Vulkan work that produces the shared input with the
// ownership-release barriers, and queues a signal operation
// for vk_sema_vk_to_cl before exporting its payload.

int fd = -1;

VkSemaphoreGetFdInfoKHR fd_info = {};
fd_info.sType = VK_STRUCTURE_TYPE_SEMAPHORE_GET_FD_INFO_KHR;
fd_info.handleType = VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT;
fd_info.semaphore = vk_sema_vk_to_cl;

vkGetSemaphoreFdKHR(device, &fd_info, &fd);
然后将该 fd 重新导入现有的 OpenCL 信号量:
clReImportSemaphoreSyncFdKHR(
    /*sema_object*/ cl_sema_vk_to_cl,
    /*properties*/  nullptr,
    /*fd*/          fd);
OpenCL 在获取共享内存之前,先等待重新导入的信号量:
clEnqueueWaitSemaphoresKHR(
    /*command_queue*/           queue,
    /*num_sema_objects*/        1,
    /*sema_objects*/            &cl_sema_vk_to_cl,
    /*sema_payload_list*/       nullptr,
    /*num_events_in_wait_list*/ 0,
    /*event_wait_list*/         nullptr,
    /*event*/                   nullptr);
接下来,按照内存共享一节所示,将获取、内核派发和释放命令加入队列。这些命令将在信号量等待完成后执行。
从 OpenCL 到 Vulkan
将向 OpenCL 到 Vulkan 方向的信号量发出信号的操作加入队列,使其在内核派发和内存释放之后执行:
clEnqueueSignalSemaphoresKHR(
    /*command_queue*/           queue,
    /*num_sema_objects*/        1,
    /*sema_objects*/            &cl_sema_cl_to_vk,
    /*sema_payload_list*/       nullptr,
    /*num_events_in_wait_list*/ 0,
    /*event_wait_list*/         nullptr,
    /*event*/                   nullptr);
然后刷新 OpenCL 队列:
clFlush(queue);这一步很重要,因为将 OpenCL 命令加入队列,并不一定会立即将其提交给设备;命令可能一直留在队列中,直到发生显式或隐式刷新。在导出 sync fd 之前,应确保等待、获取、内核派发、释放和信号命令均已发送给设备。clFlush() 可以完成这一操作,而不会阻塞等待这些命令执行完毕。
现在,将 OpenCL 信号量导出为 sync fd:
int fd = -1;

clGetSemaphoreHandleForTypeKHR(
    /*sema_object*/ cl_sema_cl_to_vk,
    /*device*/      cl_device,
    /*handle_type*/ CL_SEMAPHORE_HANDLE_SYNC_FD_KHR,
    /*handle_size*/ sizeof(fd),
    /*handle_ptr*/  &fd,
    /*size_ret*/    nullptr);
将该 fd 导入 Vulkan:
VkImportSemaphoreFdInfoKHR import_info = {};
import_info.sType = VK_STRUCTURE_TYPE_IMPORT_SEMAPHORE_FD_INFO_KHR;
import_info.semaphore = vk_sema_cl_to_vk;
import_info.flags = VK_SEMAPHORE_IMPORT_TEMPORARY_BIT;
import_info.handleType = VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT;
import_info.fd = fd;

vkImportSemaphoreFdKHR(device, &import_info);
下一次 Vulkan 队列提交会等待 vk_sema_cl_to_vk,因此,只有在 OpenCL 释放共享输出并发出完成信号后,Vulkan 才会读取该输出。
整合完整流程
前面分别介绍了内存共享和同步。现在,我们按照只需创建一次的对象,以及每一帧都需要更新的内容,来梳理完整工作流程。
初始化阶段:
1. 同时比较设备 UUID 和驱动 UUID,使 Vulkan 物理设备及驱动与 OpenCL 相匹配。
2. 查询两个 API 是否具备所选句柄类型和资源配置所需的外部内存及外部信号量能力。
3. 创建启用外部内存的 Vulkan 缓冲区或图像。
4. 分配可导出的 Vulkan 内存,将其绑定到资源,并以 VK_EXTERNAL_MEMORY_HANDLE_TYPE_OPAQUE_FD_BIT_KHR 类型导出。
5. 将该 fd 导入 OpenCL:
• 对于缓冲区和线性平铺图像,可以使用 CL_EXTERNAL_MEMORY_HANDLE_OPAQUE_FD_KHR 或 CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM。
• 对于最优平铺 Vulkan 图像,使用 CL_EXTERNAL_MEMORY_HANDLE_VULKAN_OPAQUE_FD_QCOM。
6. 为两个同步方向创建 sync fd 信号量对象:Vulkan 侧使用 VK_EXTERNAL_SEMAPHORE_HANDLE_TYPE_SYNC_FD_BIT,OpenCL 侧使用 CL_SEMAPHORE_HANDLE_SYNC_FD_KHR。
每一帧:
1. Vulkan 提交生产者工作和释放所有权的屏障,并将向 VK 到 CL 方向的 VkSemaphore 发出信号的操作加入队列。
2. Vulkan 将 VK 到 CL 的 VkSemaphore 载荷导出为一个新的 sync fd。
3. OpenCL 将该 sync fd 重新导入 VK 到 CL 的 cl_semaphore_khr。
4. OpenCL 将等待已导入 cl_semaphore_khr 的操作加入队列。
5. OpenCL 将获取共享对象的操作加入队列。
6. OpenCL 将内核派发操作加入队列。
7. OpenCL 将释放共享对象的操作加入队列。
8. OpenCL 将向 CL 到 VK 方向的 cl_semaphore_khr 发出信号的操作加入队列。
9. OpenCL 调用 clFlush(),将队列中的命令发送给设备。
10. OpenCL 将 CL 到 VK 的 cl_semaphore_khr 载荷导出为一个新的 sync fd。
11. Vulkan 将该 sync fd 导入 CL 到 VK 的 VkSemaphore。
12. Vulkan 提交获取所有权的屏障和消费者工作,并等待已导入的 VkSemaphore。
每帧流程的伪代码如下:
while (rendering) {
    // Submits the producer work and ownership-release barriers,
    // with a signal operation on the Vulkan-to-OpenCL semaphore.
    submit_vulkan_producer_release_and_signal(vk_sema_vk_to_cl);

    int vk_to_cl_fd = export_vk_semaphore_sync_fd(vk_sema_vk_to_cl);
    clReImportSemaphoreSyncFdKHR(cl_sema_vk_to_cl, nullptr, vk_to_cl_fd);

    clEnqueueWaitSemaphoresKHR(queue, 1, &cl_sema_vk_to_cl, nullptr, 0, nullptr, nullptr);

    cl_mem objects[] = {cl_input, cl_output};
    clEnqueueAcquireExternalMemObjectsKHR(queue, 2, objects, 0, nullptr, nullptr);
    clEnqueueNDRangeKernel(...);
    clEnqueueReleaseExternalMemObjectsKHR(queue, 2, objects, 0, nullptr, nullptr);

    clEnqueueSignalSemaphoresKHR(queue, 1, &cl_sema_cl_to_vk, nullptr, 0, nullptr, nullptr);

    clFlush(queue);

    int cl_to_vk_fd = export_cl_semaphore_sync_fd(cl_sema_cl_to_vk);
    import_vk_semaphore_sync_fd(vk_sema_cl_to_vk, cl_to_vk_fd);

    // Submits the ownership-acquire barriers and consumer work,
    // with a wait operation on the OpenCL-to-Vulkan semaphore.
    submit_vulkan_wait_acquire_and_consume(vk_sema_cl_to_vk);

    // Before the next iteration re-imports vk_sema_cl_to_vk, ensure this
    // Vulkan submission has completed, e.g. by waiting on a per-frame fence.
}
Adreno GPU Vulkan 代码示例框架中的 OpenCL 互操作示例

Adreno GPU Vulkan 代码示例框架包含一个 opencl_interop 示例,它以精简的端到端实现展示了前文逐步构建的流程。Vulkan 渲染场景的颜色图像,OpenCL 将其转换为灰度图像,Vulkan 再在最后的 blit 操作中使用这一结果。
为了便于比较不同的内存互操作方式,该示例提供了三种模式:缓冲区互操作、线性平铺图像互操作,以及最优平铺图像互操作。前两种模式使用通用 opaque fd 句柄,最优平铺图像模式则使用 cl_qcom_external_memory_vulkan_opaque_fd。在这些模式中,示例通过 sync fd 信号量,使执行流程从 Vulkan 转交给 OpenCL,再转回 Vulkan。
完整实现请参阅 OpenCL 互操作示例
结论
对于 Android 上的 Adreno GPU,本文介绍的 Vulkan/OpenCL 互操作方法可概括如下:
对于内存共享,一种实用方案是使用 opaque fd。Vulkan 将共享的那块内存导出为 opaque fd。随后,当通用 opaque fd 句柄足以满足需求时,OpenCL 可以用它导入缓冲区和线性平铺图像;导入最优平铺 Vulkan 图像时,则使用 cl_qcom_external_memory_vulkan_opaque_fd。
跨 API 同步应使用 sync fd。不要将它视为信号量 opaque fd 句柄:sync fd 是一次性载荷,因此每个跨 API 同步点都需要重新执行一次导出和导入操作。
最后,要记住内存所有权与执行顺序是两个独立的问题。Vulkan 队列族屏障和 OpenCL 获取和释放命令分别在各自一侧确立对共享资源的访问;外部信号量则用于安排这些操作以及 Vulkan/OpenCL 工作负载的执行顺序。
本文来自作者投稿,版权归原作者所有。如需转载,请注明出处:https://www.nxrte.com/jishu/73072.html


